ਆਪਟੀਕਲ ਅੱਖਰ ਪਛਾਣ ਹੁਣ ਰਸੀਦ ਸਕੈਨਿੰਗ, ਆਈਡੀ ਤਸਦੀਕ, ਇਨਵੌਇਸ ਆਟੋਮੇਸ਼ਨ, ਇਤਿਹਾਸਕ ਪੁਰਾਲੇਖ ਡਿਜੀਟਾਈਜ਼ੇਸ਼ਨ, ਅਤੇ ਸਟਾਈਲਸ-ਅਧਾਰਿਤ ਨੋਟ ਐਪਸ ਨੂੰ ਸ਼ਕਤੀ ਪ੍ਰਦਾਨ ਕਰਦੀ ਹੈ। OCR ਮਾਰਕੀਟ 2030 ਤੱਕ 14.8% CAGR (ਗ੍ਰੈਂਡ ਵਿਊ ਰਿਸਰਚ, 2024) 'ਤੇ $32.90 ਬਿਲੀਅਨ ਤੱਕ ਪਹੁੰਚਣ ਦਾ ਅਨੁਮਾਨ ਹੈ, ਜਿਸ ਵਿੱਚ ਬੁੱਧੀਮਾਨ ਅੱਖਰ ਪਛਾਣ - OCR ਦੀ ਹੱਥ ਲਿਖਤ-ਪੜ੍ਹਨ ਵਾਲੀ ਸ਼ਾਖਾ - ਸਭ ਤੋਂ ਤੇਜ਼ੀ ਨਾਲ ਵਧ ਰਹੀ ਹੈ। ਭਾਵੇਂ ਤੁਸੀਂ ਦਸਤਾਵੇਜ਼ ਪਾਰਸਿੰਗ, ਦ੍ਰਿਸ਼-ਟੈਕਸਟ ਖੋਜ, ਜਾਂ ਹੱਥ ਲਿਖਤ ਟ੍ਰਾਂਸਕ੍ਰਿਪਸ਼ਨ ਬਣਾ ਰਹੇ ਹੋ, ਤੁਹਾਡੇ ਦੁਆਰਾ ਸਿਖਲਾਈ ਪ੍ਰਾਪਤ OCR ਡੇਟਾਸੈਟ ਤੁਹਾਡੀ ਸ਼ੁੱਧਤਾ ਸੀਮਾ ਨਿਰਧਾਰਤ ਕਰਦਾ ਹੈ। ਇਹ ਗਾਈਡ 22 ਮੁਫ਼ਤ, ਓਪਨ-ਸੋਰਸ OCR ਡੇਟਾਸੈਟ ਨੂੰ ਕਵਰ ਕਰਦੀ ਹੈ - ਜਿਸ ਵਿੱਚ ਸਭ ਤੋਂ ਵਧੀਆ ਹੱਥ ਲਿਖਤ ਡੇਟਾਸੈਟ ਸ਼ਾਮਲ ਹਨ - ਵਰਤੋਂ ਦੇ ਕੇਸ ਦੁਆਰਾ ਸੰਗਠਿਤ ਕੀਤੇ ਗਏ ਹਨ ਅਤੇ 2024 ਤੱਕ ਸਭ ਤੋਂ ਮਜ਼ਬੂਤ ਰੀਲੀਜ਼ਾਂ ਨਾਲ ਤਾਜ਼ਾ ਕੀਤੇ ਗਏ ਹਨ।
ਕੀ ਟੇਕਵੇਅਜ਼
- OCR (ਆਪਟੀਕਲ ਕਰੈਕਟਰ ਰਿਕੋਗਨੀਸ਼ਨ): ਇੱਕ ਤਕਨਾਲੋਜੀ ਜੋ ਛਪੇ ਹੋਏ, ਦ੍ਰਿਸ਼, ਜਾਂ ਹੱਥ ਲਿਖਤ ਟੈਕਸਟ ਦੀਆਂ ਤਸਵੀਰਾਂ ਨੂੰ ਮਸ਼ੀਨ-ਪੜ੍ਹਨਯੋਗ ਡੇਟਾ ਵਿੱਚ ਬਦਲਦੀ ਹੈ।
- OCR ਡੇਟਾਸੈੱਟ ਪੰਜ ਸਮੂਹਾਂ ਵਿੱਚ ਵੰਡੇ ਗਏ ਹਨ: ਦਸਤਾਵੇਜ਼/ਰੂਪ, ਦ੍ਰਿਸ਼ ਟੈਕਸਟ, ਅੰਕ/ਅੱਖਰ, ਹੱਥ ਲਿਖਤ, ਅਤੇ ਬਹੁਭਾਸ਼ਾਈ।
- ਦਸਤਾਵੇਜ਼ OCR ਡੇਟਾਸੈੱਟ ਫਾਰਮ ਅਤੇ ਰਸੀਦਾਂ ਵਰਗੇ ਢਾਂਚਾਗਤ ਪੰਨਿਆਂ ਨੂੰ ਕੈਪਚਰ ਕਰੋ; ਸੀਨ-ਟੈਕਸਟ ਡੇਟਾਸੈੱਟ "ਜੰਗਲੀ ਵਿੱਚ" ਟੈਕਸਟ ਕੈਪਚਰ ਕਰੋ।
- IAM, MNIST, ICDAR, ਅਤੇ SROIE ਖੋਜ ਦੌਰਾਨ ਸਭ ਤੋਂ ਵੱਧ ਹਵਾਲਾ ਦਿੱਤੇ ਜਾਣ ਵਾਲੇ OCR ਬੈਂਚਮਾਰਕ ਬਣੇ ਹੋਏ ਹਨ।
- ਲਾਇਸੈਂਸ ਦੀਆਂ ਸ਼ਰਤਾਂ ਬਹੁਤ ਵੱਖਰੀਆਂ ਹੁੰਦੀਆਂ ਹਨ — ਵਪਾਰਕ ਸਿਖਲਾਈ ਤੋਂ ਪਹਿਲਾਂ ਹਰੇਕ OCR ਡੇਟਾਸੈਟ ਦੀ ਪੁਸ਼ਟੀ ਕਰੋ।
OCR (ਆਪਟੀਕਲ ਅੱਖਰ ਪਛਾਣ) ਕੀ ਹੈ?
OCR ਇੱਕ ਤਕਨੀਕ ਹੈ ਜੋ ਵੱਖ-ਵੱਖ ਕਿਸਮਾਂ ਦੇ ਦਸਤਾਵੇਜ਼ਾਂ ਨੂੰ ਬਦਲਦੀ ਹੈ, ਜਿਵੇਂ ਕਿ ਸਕੈਨ ਕੀਤੇ ਕਾਗਜ਼ੀ ਦਸਤਾਵੇਜ਼, PDF, ਜਾਂ ਟੈਕਸਟ ਦੀਆਂ ਤਸਵੀਰਾਂ, ਨੂੰ ਸੰਪਾਦਨਯੋਗ ਅਤੇ ਖੋਜਣਯੋਗ ਡੇਟਾ ਵਿੱਚ ਬਦਲਦਾ ਹੈ। ਇਹ ਇਸ ਦੁਆਰਾ ਕੰਮ ਕਰਦਾ ਹੈ:
- ਇੱਕ ਚਿੱਤਰ ਵਿੱਚ ਟੈਕਸਟ ਦੀ ਬਣਤਰ ਦਾ ਵਿਸ਼ਲੇਸ਼ਣ ਕਰਨਾ
- ਟੈਕਸਟ ਨੂੰ ਲਾਈਨਾਂ ਅਤੇ ਅੱਖਰਾਂ ਵਿੱਚ ਵੰਡਣਾ
- ਇਹਨਾਂ ਵਿਜ਼ੂਅਲ ਅੱਖਰਾਂ ਨੂੰ ਮਸ਼ੀਨ ਦੁਆਰਾ ਪੜ੍ਹਨਯੋਗ ਟੈਕਸਟ ਵਿੱਚ ਬਦਲਣਾ
ਆਮ ਵਰਤੋਂ ਵਿੱਚ ਸ਼ਾਮਲ ਹਨ:
- ਸਕੈਨ ਕੀਤੇ ਦਸਤਾਵੇਜ਼ਾਂ ਨੂੰ ਸੰਪਾਦਨਯੋਗ ਟੈਕਸਟ ਫਾਈਲਾਂ ਵਿੱਚ ਬਦਲਣਾ
- ਛਪੀਆਂ ਕਿਤਾਬਾਂ ਦਾ ਡਿਜੀਟਲੀਕਰਨ
- ਫੋਟੋਆਂ ਤੋਂ ਟੈਕਸਟ ਐਕਸਟਰੈਕਟ ਕੀਤਾ ਜਾ ਰਿਹਾ ਹੈ
- ਹੱਥ ਲਿਖਤ ਨੁਸਖੇ ਨੂੰ ਡਿਜੀਟਲ ਟੈਕਸਟ ਵਿੱਚ ਬਦਲਣਾ
- ਲਾਇਸੰਸ ਪਲੇਟ ਮਾਨਤਾ
ਤੁਸੀਂ ਸਹੀ OCR ਡੇਟਾਸੈੱਟ ਕਿਵੇਂ ਚੁਣਦੇ ਹੋ?
OCR ਡੇਟਾਸੈਟ ਦੀ ਚੋਣ ਚਾਰ ਕਾਰਕਾਂ 'ਤੇ ਨਿਰਭਰ ਕਰਦੀ ਹੈ: ਟੈਕਸਟ ਕਿਸਮ, ਕੈਪਚਰ ਵਾਤਾਵਰਣ, ਐਨੋਟੇਸ਼ਨ ਗ੍ਰੈਨਿਊਲੈਰਿਟੀ, ਅਤੇ ਲਾਇਸੈਂਸ। ਪ੍ਰਿੰਟਿਡ-ਡੌਕੂਮੈਂਟ OCR ਨੂੰ ਹੱਥ ਲਿਖਤ ਕਰਸਿਵ ਜਾਂ ਕਰਵਡ ਸੀਨ ਟੈਕਸਟ ਨਾਲੋਂ ਵੱਖਰੇ ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ। ਦਸਤਾਵੇਜ਼ ਡੇਟਾਸੈਟ ਇਨਵੌਇਸ, ਫਾਰਮ ਅਤੇ ਰਸੀਦਾਂ ਦੇ ਅਨੁਕੂਲ ਹੁੰਦੇ ਹਨ; ਦ੍ਰਿਸ਼-ਟੈਕਸਟ ਡੇਟਾਸੈਟ ਸਾਈਨੇਜ ਅਤੇ ਉਤਪਾਦ ਰੀਡਿੰਗ ਦੇ ਅਨੁਕੂਲ ਹੁੰਦੇ ਹਨ; ਹੱਥ ਲਿਖਤ ਡੇਟਾਸੈਟ ਨੋਟਸ, ਹੱਥ-ਲਿਖਤਾਂ ਅਤੇ ਸਟਾਈਲਸ ਇਨਪੁੱਟ ਦੇ ਅਨੁਕੂਲ ਹੁੰਦੇ ਹਨ। ਸ਼ਬਦ-ਪੱਧਰ ਅਤੇ ਲਾਈਨ-ਪੱਧਰ ਐਨੋਟੇਸ਼ਨ ਪੂਰੇ OCR ਪਾਈਪਲਾਈਨਾਂ ਦਾ ਸਮਰਥਨ ਕਰਦੇ ਹਨ, ਜਦੋਂ ਕਿ ਅੱਖਰ-ਪੱਧਰ ਸੈੱਟ ਵਰਗੀਕਰਨ ਬੇਸਲਾਈਨਾਂ ਦੇ ਅਨੁਕੂਲ ਹੁੰਦੇ ਹਨ। ਹਮੇਸ਼ਾ ਲਾਇਸੈਂਸ ਸ਼ਰਤਾਂ ਦੀ ਪੁਸ਼ਟੀ ਕਰੋ, ਕਿਉਂਕਿ ਕੁਝ OCR ਡੇਟਾਸੈਟ ਸਿਰਫ਼ ਖੋਜ-ਅਧਾਰਤ ਹਨ ਜਾਂ ਰਜਿਸਟ੍ਰੇਸ਼ਨ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ।
ਸਭ ਤੋਂ ਵਧੀਆ ਦਸਤਾਵੇਜ਼ ਅਤੇ ਫਾਰਮ OCR ਡੇਟਾਸੈੱਟ ਕਿਹੜੇ ਹਨ?
ਦਸਤਾਵੇਜ਼ OCR ਡੇਟਾਸੈੱਟ ਮਾਡਲਾਂ ਨੂੰ ਇਨਵੌਇਸ, ਫਾਰਮ, ਰਸੀਦਾਂ, ਅਤੇ ਆਈਡੀ ਵਰਗੇ ਢਾਂਚਾਗਤ ਪੰਨਿਆਂ ਨੂੰ ਪਾਰਸ ਕਰਨ ਲਈ ਸਿਖਲਾਈ ਦਿੰਦੇ ਹਨ। ਇਹ ਕਾਰੋਬਾਰੀ ਦਸਤਾਵੇਜ਼ ਆਟੋਮੇਸ਼ਨ ਅਤੇ ਕੁੰਜੀ-ਮੁੱਲ ਕੱਢਣ ਨੂੰ ਸ਼ਕਤੀ ਦਿੰਦੇ ਹਨ।
- ਫਨਸਡੀ — ਸ਼ੋਰ-ਸ਼ਰਾਬੇ ਵਾਲੇ, ਅਸਲ-ਸੰਸਾਰ ਦਿੱਖ ਵਾਲੇ 199 ਐਨੋਟੇਟਡ ਸਕੈਨ ਕੀਤੇ ਫਾਰਮ। ਫਾਰਮ ਸਮਝ ਅਤੇ ਕੁੰਜੀ-ਮੁੱਲ ਕੱਢਣ ਲਈ ਮਿਆਰੀ ਮਾਪਦੰਡ।
- ਸਰੋਈ — ICDAR 2019 ਸਕੈਨ-ਰਸੀਦ ਡੇਟਾਸੈਟ ਲਗਭਗ 1,000 ਰਸੀਦਾਂ ਦਾ, ਜੋ ਇੱਕ ਸਿੰਗਲ ਸੈੱਟ ਵਿੱਚ ਟੈਕਸਟ ਖੋਜ, ਪਛਾਣ ਅਤੇ ਜਾਣਕਾਰੀ ਕੱਢਣ ਦਾ ਸਮਰਥਨ ਕਰਦਾ ਹੈ।
- ਰੱਸੀ — ਪੋਸਟ-ਓਸੀਆਰ ਪਾਰਸਿੰਗ ਲਈ ਬਣਾਇਆ ਗਿਆ ਇੱਕ ਏਕੀਕ੍ਰਿਤ ਰਸੀਦ ਡੇਟਾਸੈੱਟ, ਇਨਵੌਇਸ ਅਤੇ ਰਸੀਦ ਆਟੋਮੇਸ਼ਨ ਲਈ ਅਮੀਰ ਫੀਲਡ-ਪੱਧਰੀ ਲੇਬਲਾਂ ਦੇ ਨਾਲ।
- XFUND — FUNSD ਦਾ ਬਹੁਭਾਸ਼ਾਈ ਐਕਸਟੈਂਸ਼ਨ ਜੋ ਸੱਤ ਭਾਸ਼ਾਵਾਂ (ਜਰਮਨ, ਸਪੈਨਿਸ਼, ਫ੍ਰੈਂਚ, ਇਤਾਲਵੀ, ਜਾਪਾਨੀ, ਪੁਰਤਗਾਲੀ, ਚੀਨੀ) ਨੂੰ ਕਵਰ ਕਰਦਾ ਹੈ, ਹਰੇਕ 199 ਪੰਨਿਆਂ ਦੇ ਨਾਲ। ਬਹੁਭਾਸ਼ਾਈ ਦਸਤਾਵੇਜ਼ AI ਲਈ ਆਦਰਸ਼।
- ਡੀਡੀਆਈ-100 — ਸਕਿਊ, ਬਲਰ, ਅਤੇ ਸ਼ੋਰ ਵਰਗੇ ਅਸਲ-ਸੰਸਾਰ ਦੇ ਡਿਗ੍ਰੇਡੇਸ਼ਨ ਦੇ ਤਹਿਤ ਖੋਜ ਅਤੇ ਪਛਾਣ ਲਈ ਲਗਭਗ 100,000 ਵਿਗੜੇ ਹੋਏ ਦਸਤਾਵੇਜ਼ ਚਿੱਤਰ।
ਸਭ ਤੋਂ ਵਧੀਆ ਸੀਨ ਟੈਕਸਟ OCR ਡੇਟਾਸੈੱਟ ਕਿਹੜੇ ਹਨ?
ਸੀਨ-ਟੈਕਸਟ OCR ਡੇਟਾਸੈੱਟ ਮਾਡਲਾਂ ਨੂੰ ਕੁਦਰਤੀ ਚਿੱਤਰਾਂ ਜਿਵੇਂ ਕਿ ਚਿੰਨ੍ਹ, ਉਤਪਾਦ ਅਤੇ ਗਲੀ ਦੇ ਦ੍ਰਿਸ਼ਾਂ ਵਿੱਚ ਟੈਕਸਟ ਪੜ੍ਹਨ ਲਈ ਸਿਖਲਾਈ ਦਿੰਦੇ ਹਨ। ਇਹ ਜੰਗਲੀ OCR ਲਈ ਜ਼ਰੂਰੀ ਹਨ ਜਿੱਥੇ ਪਿਛੋਕੜ ਬੇਤਰਤੀਬ ਹੁੰਦੇ ਹਨ।
- ਆਈਸੀਡੀਏਆਰ ਰੋਬਸਟ ਰੀਡਿੰਗ — ਜ਼ਿਆਦਾਤਰ ਦ੍ਰਿਸ਼-ਪਾਠ ਖੋਜ ਦੇ ਪਿੱਛੇ ਬੈਂਚਮਾਰਕ ਪਰਿਵਾਰ, ਜਿਸ ਵਿੱਚ ਸ਼ਬਦ-ਪੱਧਰੀ ਸੀਮਾ ਬਕਸੇ ਅਤੇ ਟ੍ਰਾਂਸਕ੍ਰਿਪਸ਼ਨਾਂ ਨਾਲ ਫੋਕਸਡ ਅਤੇ ਇੰਸੀਡੈਂਟਲ ਸੀਨ ਟੈਕਸਟ ਚੁਣੌਤੀਆਂ ਸ਼ਾਮਲ ਹਨ।
- ਕੋਕੋ-ਟੈਕਸਟ — MS-COCO ਚਿੱਤਰਾਂ 'ਤੇ ਵੱਡੇ ਪੈਮਾਨੇ ਦੇ ਦ੍ਰਿਸ਼-ਟੈਕਸਟ ਐਨੋਟੇਸ਼ਨ। ਕੁਦਰਤੀ ਦ੍ਰਿਸ਼ਾਂ ਵਿੱਚ ਪੈਮਾਨੇ 'ਤੇ ਟੈਕਸਟ ਖੋਜ ਲਈ ਮਜ਼ਬੂਤ।
- ਕੁੱਲ-ਲਿਖਤ — ਵਕਰ ਅਤੇ ਮਨਮਾਨੇ ਢੰਗ ਨਾਲ ਬਣਾਏ ਟੈਕਸਟ ਵਿੱਚ ਮੁਹਾਰਤ ਰੱਖਦਾ ਹੈ, ਜੋ ਕਿ ਪੁਰਾਣੇ OCR ਮਾਡਲਾਂ ਲਈ ਇੱਕ ਜਾਣਿਆ-ਪਛਾਣਿਆ ਕਮਜ਼ੋਰੀ ਹੈ।
- SVT (ਸਟ੍ਰੀਟ ਵਿਊ ਟੈਕਸਟ) — ਗੂਗਲ ਸਟਰੀਟ ਵਿਊ ਤੋਂ ਇਕੱਠੀਆਂ ਕੀਤੀਆਂ ਗਈਆਂ ਸ਼ਬਦ ਤਸਵੀਰਾਂ, ਅਕਸਰ ਘੱਟ-ਰੈਜ਼ੋਲਿਊਸ਼ਨ ਅਤੇ ਉੱਚ-ਪਰਿਵਰਤਨਸ਼ੀਲਤਾ। ਕੋਡ ਮਿਰਰਾਂ ਵਾਲੇ ਪੇਪਰਾਂ ਰਾਹੀਂ ਉਪਲਬਧ।
- ਹਾਇਰਟੈਕਸਟ — ਪੈਰਾਗ੍ਰਾਫ਼ ਤੋਂ ਲਾਈਨ ਤੋਂ ਸ਼ਬਦ ਤੱਕ ਲੜੀਵਾਰ ਐਨੋਟੇਸ਼ਨ, ਹੱਥ ਲਿਖਤ ਅਤੇ ਛਪੇ ਹੋਏ ਦ੍ਰਿਸ਼ ਟੈਕਸਟ ਦੋਵਾਂ ਨੂੰ ਕਵਰ ਕਰਦਾ ਹੈ। ਲੇਆਉਟ-ਜਾਗਰੂਕ OCR ਲਈ ਉਪਯੋਗੀ।
ਸਭ ਤੋਂ ਵਧੀਆ ਅੰਕ ਅਤੇ ਅੱਖਰ OCR ਡੇਟਾਸੈੱਟ ਕਿਹੜੇ ਹਨ?
ਅੰਕ ਅਤੇ ਅੱਖਰ OCR ਡੇਟਾਸੈੱਟ ਮਾਡਲਾਂ ਨੂੰ ਨਿਯੰਤਰਿਤ ਸੈਟਿੰਗਾਂ ਵਿੱਚ ਵਿਅਕਤੀਗਤ ਚਿੰਨ੍ਹਾਂ ਦੀ ਪਛਾਣ ਕਰਨ ਲਈ ਸਿਖਲਾਈ ਦਿੰਦੇ ਹਨ। ਇਹ ਵਰਗੀਕਰਨ ਬੇਸਲਾਈਨਾਂ ਲਈ ਮਿਆਰੀ ਸ਼ੁਰੂਆਤੀ ਬਿੰਦੂ ਹਨ।
- MNIST — 70,000 ਗ੍ਰੇਸਕੇਲ ਹੱਥ ਲਿਖਤ ਅੰਕ ਚਿੱਤਰ। ਇੱਕ ਅੰਕ ਵਰਗੀਕਰਣ ਨੂੰ ਪ੍ਰਮਾਣਿਤ ਕਰਨ ਲਈ ਸਭ ਤੋਂ ਤੇਜ਼ ਬੇਸਲਾਈਨ।
- ਐਮਨਿਸਟ — NIST ਸਪੈਸ਼ਲ ਡੇਟਾਬੇਸ 19 ਤੋਂ ਪ੍ਰਾਪਤ 814,255 ਹੱਥ ਲਿਖਤ ਅੱਖਰਾਂ ਅਤੇ ਅੰਕਾਂ ਨਾਲ MNIST ਦਾ ਵਿਸਤਾਰ ਕਰਦਾ ਹੈ।
- SVHN (ਸਟ੍ਰੀਟ ਵਿਊ ਹਾਊਸ ਨੰਬਰ) — ਘਰਾਂ ਦੇ ਨੰਬਰਾਂ ਤੋਂ 600,000 ਤੋਂ ਵੱਧ ਅਸਲ-ਸੰਸਾਰ ਅੰਕ ਚਿੱਤਰ। ਸ਼ੋਰ-ਸ਼ਰਾਬੇ ਵਾਲੀਆਂ ਸਥਿਤੀਆਂ ਲਈ MNIST ਵੱਲੋਂ ਇੱਕ ਵਿਹਾਰਕ ਕਦਮ।
- ਅੱਖਰ 74K — ਕੁਦਰਤੀ ਚਿੱਤਰਾਂ ਅਤੇ ਕੰਪਿਊਟਰ ਫੌਂਟਾਂ ਤੋਂ ਅੰਗਰੇਜ਼ੀ ਅਤੇ ਕੰਨੜ ਅੱਖਰਾਂ ਨੂੰ ਕਵਰ ਕਰਨ ਵਾਲੀਆਂ 74,107 ਤਸਵੀਰਾਂ।
- NIST ਸਪੈਸ਼ਲ ਡੇਟਾਬੇਸ 19 — 3,600 ਲੇਖਕਾਂ ਤੋਂ 810,000+ ਹੱਥ-ਪ੍ਰਿੰਟ ਕੀਤੇ ਅੱਖਰ ਚਿੱਤਰ। ਬਹੁਤ ਸਾਰੇ ਅੰਗਰੇਜ਼ੀ OCR ਬੈਂਚਮਾਰਕ ਜਿਸ ਸਰੋਤ ਤੋਂ ਪ੍ਰਾਪਤ ਹੁੰਦੇ ਹਨ।
OCR ਲਈ ਸਭ ਤੋਂ ਵਧੀਆ ਹੱਥ ਲਿਖਤ ਡੇਟਾਸੈੱਟ ਕਿਹੜੇ ਹਨ?
ਹੱਥ ਲਿਖਤ ਡੇਟਾਸੈੱਟ OCR ਮਾਡਲਾਂ ਨੂੰ ਕਰਸਿਵ, ਪ੍ਰਿੰਟਿਡ, ਅਤੇ ਇਤਿਹਾਸਕ ਹੱਥ ਲਿਖਤ ਟੈਕਸਟ ਪੜ੍ਹਨ ਲਈ ਸਿਖਲਾਈ ਦਿੰਦੇ ਹਨ। ਸਭ ਤੋਂ ਮਜ਼ਬੂਤ ਓਪਨ ਹੈਂਡਰਾਈਟਿੰਗ ਡੇਟਾਸੈੱਟ ਹੱਥ ਲਿਖਤ ਟੈਕਸਟ ਪਛਾਣ (HTR) ਲਈ ਸਭ ਤੋਂ ਵੱਧ ਹਵਾਲਾ ਦਿੱਤੇ ਜਾਣ ਵਾਲੇ ਬੈਂਚਮਾਰਕ ਬਣੇ ਹੋਏ ਹਨ।
- IAM ਹੱਥ ਲਿਖਤ ਡੇਟਾਬੇਸ — ਅੰਗਰੇਜ਼ੀ ਹੱਥ ਲਿਖਤ ਸੋਨੇ ਦਾ ਮਿਆਰ, 657 ਲੇਖਕਾਂ ਦੀਆਂ 13,353 ਟੈਕਸਟ ਲਾਈਨਾਂ ਦੇ ਨਾਲ। 2024-2025 OCR ਖੋਜ ਵਿੱਚ ਅਜੇ ਵੀ ਸਭ ਤੋਂ ਵੱਧ ਹਵਾਲਾ ਦਿੱਤਾ ਗਿਆ ਹੱਥ ਲਿਖਤ ਡੇਟਾਸੈਟ ਹੈ।
- ਆਈਏਐਮ-ਆਨਡੀਬੀ — IAM ਦਾ ਔਨਲਾਈਨ ਪੈੱਨ-ਸਟ੍ਰੋਕ ਸੰਸਕਰਣ, ਟ੍ਰੈਜੈਕਟਰੀ ਡੇਟਾ ਨੂੰ ਕੈਪਚਰ ਕਰਦਾ ਹੈ। ਸਟਾਈਲਸ ਅਤੇ ਟੈਬਲੇਟ ਪਛਾਣ ਲਈ ਕੈਨੋਨੀਕਲ ਹੈਂਡਰਾਈਟਿੰਗ ਡੇਟਾਸੈਟ।
- ਬੈਂਥਮ ਪੇਪਰਸ — ਦਾਰਸ਼ਨਿਕ ਜੇਰੇਮੀ ਬੇਂਥਮ ਤੋਂ ਲਿਖਤੀ ਇਤਿਹਾਸਕ ਅੰਗਰੇਜ਼ੀ ਹੱਥ-ਲਿਖਤਾਂ। ਇਤਿਹਾਸਕ ਹੱਥ-ਲਿਖਤ OCR ਲਈ ਪ੍ਰਮੁੱਖ ਮਾਪਦੰਡ, ਟ੍ਰਾਂਸਕ੍ਰਿਬਸ ਰਾਹੀਂ ਪਹੁੰਚਯੋਗ।
- GNHK (ਗੁੱਡਨੋਟਸ ਹੈਂਡਰਾਈਟਿੰਗ ਕਲੈਕਸ਼ਨ) — 2021 ਦਾ ਇੱਕ ਡੇਟਾਸੈਟ ਜੋ ਅਸਲ-ਸੰਸਾਰ ਦੇ ਅੰਗਰੇਜ਼ੀ ਹੱਥ ਲਿਖਤ ਨੋਟਸ ਵਿੱਚ ਬੇਰੋਕ ਹੈ। ਲੈਬ-ਸਾਫ਼ IAM ਨਾਲੋਂ ਗੜਬੜ ਵਾਲੇ ਉਤਪਾਦਨ ਡੇਟਾ ਦੇ ਨੇੜੇ।
ਸਭ ਤੋਂ ਵਧੀਆ ਬਹੁ-ਭਾਸ਼ਾਈ ਅਤੇ ਗੈਰ-ਲਾਤੀਨੀ OCR ਡੇਟਾਸੈੱਟ ਕਿਹੜੇ ਹਨ?
ਬਹੁ-ਭਾਸ਼ਾਈ OCR ਡੇਟਾਸੈੱਟ ਅੰਗਰੇਜ਼ੀ ਤੋਂ ਪਰੇ ਲਿਪੀਆਂ 'ਤੇ ਮਾਡਲਾਂ ਨੂੰ ਸਿਖਲਾਈ ਦਿੰਦੇ ਹਨ, ਜਿਸ ਵਿੱਚ ਚੀਨੀ, ਅਰਬੀ ਅਤੇ ਗਣਿਤਿਕ ਸੰਕੇਤ ਸ਼ਾਮਲ ਹਨ। ਇਹ ਗਲੋਬਲ ਦਸਤਾਵੇਜ਼ ਅਤੇ ਹੱਥ ਲਿਖਤ ਪਛਾਣ ਲਈ ਜ਼ਰੂਰੀ ਹਨ।
- ਕੈਸੀਆ-ਐਚਡਬਲਯੂਡੀਬੀ — ਮਿਆਰੀ ਚੀਨੀ OCR ਬੈਂਚਮਾਰਕ, 1,020 ਲੇਖਕਾਂ ਦੇ 1.17 ਮਿਲੀਅਨ ਹੱਥ ਲਿਖਤ ਅੱਖਰਾਂ ਦੇ ਨਮੂਨਿਆਂ ਦੇ ਨਾਲ।
- ਖੱਟ — 1,000 ਵੱਖ-ਵੱਖ ਲੇਖਕਾਂ ਦੇ 1,000 ਅਰਬੀ ਹੱਥ ਲਿਖਤ ਫਾਰਮ, ਕਈ ਰੈਜ਼ੋਲਿਊਸ਼ਨਾਂ 'ਤੇ ਸਕੈਨ ਕੀਤੇ ਗਏ। ਸਭ ਤੋਂ ਵਿਆਪਕ ਖੁੱਲ੍ਹਾ ਅਰਬੀ OCR ਡੇਟਾਸੈਟ।
- ਕਰੋਮ — ਔਨਲਾਈਨ ਹੱਥ ਲਿਖਤ ਗਣਿਤਿਕ ਸਮੀਕਰਨਾਂ ਦੀ ਮਾਨਤਾ 'ਤੇ ਮੁਕਾਬਲਾ: 101+ ਗਣਿਤ ਚਿੰਨ੍ਹਾਂ ਵਿੱਚ 10,000+ ਸਮੀਕਰਨ, ਔਨਲਾਈਨ ਅਤੇ ਔਫਲਾਈਨ ਦੋਵਾਂ ਰੂਪਾਂ ਵਿੱਚ। ਹੱਥ ਲਿਖਤ ਸਮੀਕਰਨ OCR ਲਈ ਜ਼ਰੂਰੀ।
ਮੁਫ਼ਤ OCR ਡੇਟਾਸੈੱਟਾਂ ਦੀ ਵਰਤੋਂ ਕਰਦੇ ਸਮੇਂ ਆਮ ਨੁਕਸਾਨ ਕੀ ਹਨ?
ਤਿੰਨ ਮੁਸ਼ਕਲਾਂ ਜ਼ਿਆਦਾਤਰ ਟੀਮਾਂ ਨੂੰ ਘੇਰਦੀਆਂ ਹਨ।
ਡੋਮੇਨ ਮੇਲ ਨਹੀਂ ਖਾਂਦਾ: ਸਾਫ਼ IAM ਜਾਂ COCO-ਟੈਕਸਟ 'ਤੇ ਸਿਖਲਾਈ ਅਤੇ ਕੁਚਲੇ ਹੋਏ ਇਨਵੌਇਸਾਂ 'ਤੇ ਤੈਨਾਤ ਕਰਨਾ ਮਾੜੀ ਸ਼ੁੱਧਤਾ ਦੀ ਗਰੰਟੀ ਦਿੰਦਾ ਹੈ।
ਲਾਇਸੈਂਸ ਅੰਨ੍ਹਾਪਣ: ਕਈ ਦ੍ਰਿਸ਼-ਟੈਕਸਟ ਅਤੇ ਇਤਿਹਾਸਕ OCR ਡੇਟਾਸੈੱਟ ਸਿਰਫ਼ ਖੋਜ ਲਈ ਹਨ ਜਾਂ ਵਪਾਰਕ ਵਰਤੋਂ ਤੋਂ ਪਹਿਲਾਂ ਰਜਿਸਟ੍ਰੇਸ਼ਨ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ।
ਐਨੋਟੇਸ਼ਨ ਗੈਪ: ਬਹੁਤ ਸਾਰੇ OCR ਡੇਟਾਸੈੱਟਾਂ ਵਿੱਚ ਲੇਆਉਟ ਮੈਟਾਡੇਟਾ, ਲਾਈਨ-ਲੈਵਲ ਬਾਊਂਡਿੰਗ ਬਾਕਸ, ਜਾਂ ਫੀਲਡ ਲੇਬਲ ਦੀ ਘਾਟ ਹੁੰਦੀ ਹੈ ਜਿਨ੍ਹਾਂ ਦੀ ਉਤਪਾਦਨ ਪ੍ਰਣਾਲੀਆਂ ਨੂੰ ਲੋੜ ਹੁੰਦੀ ਹੈ।
ਇੱਕ ਮੱਧ-ਆਕਾਰ ਦੀ ਲੌਜਿਸਟਿਕਸ ਫਰਮ ਦੀ ਕਲਪਨਾ ਕਰੋ ਜੋ ਸ਼ਿਪਿੰਗ-ਲੇਬਲ ਰੀਡਿੰਗ ਨੂੰ ਸਵੈਚਾਲਿਤ ਕਰ ਰਹੀ ਹੈ। ਜਨਤਕ ਦ੍ਰਿਸ਼-ਟੈਕਸਟ ਸਿਖਲਾਈ ਉਹਨਾਂ ਨੂੰ ਬੈਂਚਮਾਰਕਾਂ 'ਤੇ 80% ਤੱਕ ਪਹੁੰਚਾਉਂਦੀ ਹੈ, ਪਰ ਚਮਕ ਅਤੇ ਫੋਲਡ ਵਾਲੇ ਅਸਲ ਲੇਬਲ ਉਹਨਾਂ ਨੂੰ 58% ਤੱਕ ਘਟਾ ਦਿੰਦੇ ਹਨ। ਇਸ ਪਾੜੇ ਨੂੰ ਪੂਰਾ ਕਰਨ ਲਈ ਲਾਂਚ ਤੋਂ ਪਹਿਲਾਂ 6,000 ਇਨ-ਡੋਮੇਨ ਲੇਬਲ ਚਿੱਤਰਾਂ ਦੇ ਨਿਸ਼ਾਨਾਬੱਧ ਡੇਟਾ ਐਨੋਟੇਸ਼ਨ ਦੀ ਲੋੜ ਸੀ।
ਓਪਨ-ਸਰੋਤ ਡੇਟਾਸੈਟਾਂ ਦੇ ਲਾਭ ਅਤੇ ਚੁਣੌਤੀਆਂ
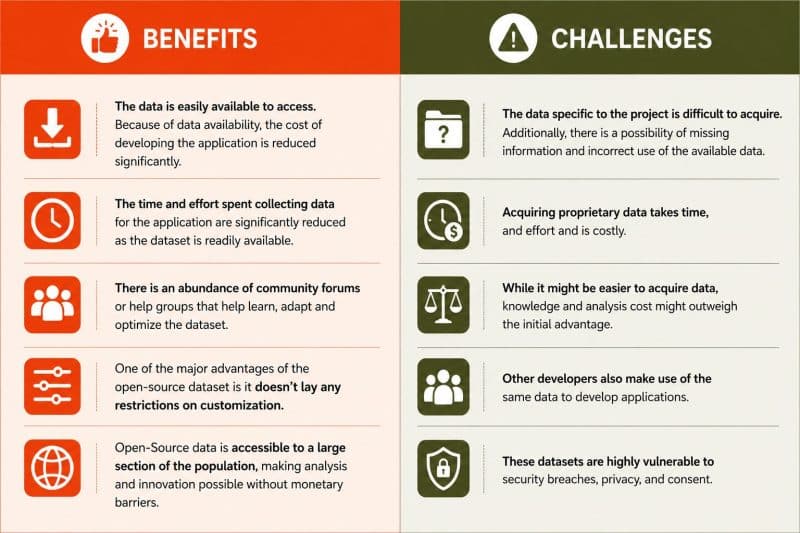
ਕਾਰੋਬਾਰਾਂ ਨੂੰ ਇਹ ਸਮਝਣ ਲਈ ਇੱਕ ਦੂਜੇ ਦੇ ਵਿਰੁੱਧ ਲਾਭਾਂ ਅਤੇ ਚੁਣੌਤੀਆਂ ਦਾ ਸਾਹਮਣਾ ਕਰਨ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ ਕਿ ਕੀ ਉਹਨਾਂ ਨੂੰ ਉਹਨਾਂ ਦੀਆਂ ML ਐਪਲੀਕੇਸ਼ਨਾਂ ਲਈ ਮੁਫਤ-ਟੂ-ਵਰਤੋਂ ਵਾਲੇ ਡੇਟਾ ਦੀ ਚੋਣ ਕਰਨੀ ਚਾਹੀਦੀ ਹੈ।
ਲਾਭ
- ਡਾਟਾ ਆਸਾਨੀ ਨਾਲ ਐਕਸੈਸ ਕਰਨ ਲਈ ਉਪਲਬਧ ਹੈ. ਡੇਟਾ ਉਪਲਬਧਤਾ ਦੇ ਕਾਰਨ, ਐਪਲੀਕੇਸ਼ਨ ਨੂੰ ਵਿਕਸਤ ਕਰਨ ਦੀ ਲਾਗਤ ਕਾਫ਼ੀ ਘੱਟ ਗਈ ਹੈ.
- ਐਪਲੀਕੇਸ਼ਨ ਲਈ ਡੇਟਾ ਇਕੱਠਾ ਕਰਨ ਵਿੱਚ ਖਰਚਿਆ ਸਮਾਂ ਅਤੇ ਮਿਹਨਤ ਕਾਫ਼ੀ ਘੱਟ ਜਾਂਦੀ ਹੈ ਕਿਉਂਕਿ ਡੇਟਾਸੈਟ ਆਸਾਨੀ ਨਾਲ ਉਪਲਬਧ ਹੁੰਦਾ ਹੈ।
- ਇੱਥੇ ਬਹੁਤ ਸਾਰੇ ਭਾਈਚਾਰਕ ਫੋਰਮਾਂ ਜਾਂ ਮਦਦ ਸਮੂਹ ਹਨ ਜੋ ਡੇਟਾਸੈਟ ਨੂੰ ਸਿੱਖਣ, ਅਨੁਕੂਲਿਤ ਕਰਨ ਅਤੇ ਅਨੁਕੂਲ ਬਣਾਉਣ ਵਿੱਚ ਮਦਦ ਕਰਦੇ ਹਨ।
- ਓਪਨ-ਸੋਰਸ ਡੇਟਾਸੈਟ ਦਾ ਇੱਕ ਵੱਡਾ ਫਾਇਦਾ ਇਹ ਹੈ ਕਿ ਇਹ ਕਸਟਮਾਈਜ਼ੇਸ਼ਨ 'ਤੇ ਕੋਈ ਪਾਬੰਦੀਆਂ ਨਹੀਂ ਲਾਉਂਦਾ ਹੈ।
- ਓਪਨ-ਸਰੋਤ ਡੇਟਾ ਆਬਾਦੀ ਦੇ ਇੱਕ ਵੱਡੇ ਹਿੱਸੇ ਲਈ ਪਹੁੰਚਯੋਗ ਹੈ, ਜਿਸ ਨਾਲ ਮੁਦਰਾ ਰੁਕਾਵਟਾਂ ਦੇ ਬਿਨਾਂ ਵਿਸ਼ਲੇਸ਼ਣ ਅਤੇ ਨਵੀਨਤਾ ਸੰਭਵ ਹੋ ਜਾਂਦੀ ਹੈ।
ਚੁਣੌਤੀ
- ਪ੍ਰੋਜੈਕਟ ਲਈ ਖਾਸ ਡੇਟਾ ਪ੍ਰਾਪਤ ਕਰਨਾ ਮੁਸ਼ਕਲ ਹੈ। ਇਸ ਤੋਂ ਇਲਾਵਾ, ਜਾਣਕਾਰੀ ਦੇ ਗੁੰਮ ਹੋਣ ਅਤੇ ਉਪਲਬਧ ਡੇਟਾ ਦੀ ਗਲਤ ਵਰਤੋਂ ਦੀ ਸੰਭਾਵਨਾ ਹੈ।
- ਮਲਕੀਅਤ ਡੇਟਾ ਨੂੰ ਪ੍ਰਾਪਤ ਕਰਨ ਵਿੱਚ ਸਮਾਂ ਅਤੇ ਮਿਹਨਤ ਲੱਗਦੀ ਹੈ ਅਤੇ ਇਹ ਮਹਿੰਗਾ ਹੈ
- ਹਾਲਾਂਕਿ ਡੇਟਾ ਪ੍ਰਾਪਤ ਕਰਨਾ ਆਸਾਨ ਹੋ ਸਕਦਾ ਹੈ, ਗਿਆਨ ਅਤੇ ਵਿਸ਼ਲੇਸ਼ਣ ਦੀ ਲਾਗਤ ਸ਼ੁਰੂਆਤੀ ਫਾਇਦੇ ਤੋਂ ਵੱਧ ਹੋ ਸਕਦੀ ਹੈ।
- ਹੋਰ ਡਿਵੈਲਪਰ ਵੀ ਐਪਲੀਕੇਸ਼ਨਾਂ ਨੂੰ ਵਿਕਸਤ ਕਰਨ ਲਈ ਉਸੇ ਡੇਟਾ ਦੀ ਵਰਤੋਂ ਕਰਦੇ ਹਨ।
- ਇਹ ਡੇਟਾਸੈੱਟ ਸੁਰੱਖਿਆ ਉਲੰਘਣਾਵਾਂ, ਗੋਪਨੀਯਤਾ ਅਤੇ ਸਹਿਮਤੀ ਲਈ ਬਹੁਤ ਜ਼ਿਆਦਾ ਕਮਜ਼ੋਰ ਹਨ।
ਸ਼ੈਪ OCR ਅਤੇ ਹੱਥ ਲਿਖਤ ਪਛਾਣ ਪ੍ਰੋਜੈਕਟਾਂ ਦਾ ਸਮਰਥਨ ਕਿਵੇਂ ਕਰਦਾ ਹੈ?
ਸ਼ਾਈਪ ਦੀਆਂ OCR ਸਿਖਲਾਈ ਡੇਟਾ ਸੇਵਾਵਾਂ 60+ ਭਾਸ਼ਾਵਾਂ ਵਿੱਚ ਕਸਟਮ ਡੇਟਾ ਸੰਗ੍ਰਹਿ ਦੇ ਨਾਲ ਓਪਨ-ਡੇਟਾਸੈੱਟ ਕਿਊਰੇਸ਼ਨ ਨੂੰ ਜੋੜਦੀਆਂ ਹਨ , ਜਿਸ ਵਿੱਚ ਪ੍ਰਿੰਟ ਕੀਤੇ ਦਸਤਾਵੇਜ਼, ਹੱਥ ਲਿਖਤ, ਰਸੀਦਾਂ ਅਤੇ ID ਸ਼ਾਮਲ ਹਨ। ਸ਼ਾਈਪ ਦੇ ਐਨੋਟੇਸ਼ਨ ਵਰਕਫਲੋ ਜਨਤਕ OCR ਡੇਟਾਸੈੱਟਾਂ ਦੀਆਂ ਪਰਤਾਂ ਨੂੰ ਜੋੜਦੇ ਹਨ: ਲਾਈਨ-ਲੈਵਲ ਬਾਊਂਡਿੰਗ ਬਾਕਸ, ਫੀਲਡ-ਲੈਵਲ ਲੇਬਲ, ਟ੍ਰਾਂਸਕ੍ਰਿਪਸ਼ਨ QC, ਅਤੇ ਲੇਖਕ ਮੈਟਾਡੇਟਾ।
ਸਿੱਟਾ
ਉੱਪਰ ਦਿੱਤੇ 22 OCR ਡੇਟਾਸੈੱਟ ਤੁਹਾਨੂੰ 2026 ਲਈ ਦਸਤਾਵੇਜ਼, ਦ੍ਰਿਸ਼ ਟੈਕਸਟ, ਅੰਕ, ਹੱਥ ਲਿਖਤ, ਅਤੇ ਬਹੁਭਾਸ਼ਾਈ ਮਾਨਤਾ ਵਿੱਚ ਇੱਕ ਸੰਪੂਰਨ ਓਪਨ-ਸੋਰਸ ਬੁਨਿਆਦ ਪ੍ਰਦਾਨ ਕਰਦੇ ਹਨ। OCR ਡੇਟਾਸੈਟ ਨਾਲ ਸ਼ੁਰੂਆਤ ਕਰੋ ਜੋ ਤੁਹਾਡੇ ਟੈਕਸਟ ਕਿਸਮ ਅਤੇ ਕੈਪਚਰ ਵਾਤਾਵਰਣ ਨਾਲ ਮੇਲ ਖਾਂਦਾ ਹੈ, ਆਪਣੇ ਅਸਲ ਡੇਟਾ ਦੇ ਇੱਕ ਰੱਖੇ ਹੋਏ ਨਮੂਨੇ ਦੇ ਵਿਰੁੱਧ ਪ੍ਰਮਾਣਿਤ ਕਰੋ, ਅਤੇ ਡੋਮੇਨ ਪਾੜੇ ਨੂੰ ਬੰਦ ਕਰਨ ਲਈ ਕਸਟਮ ਐਨੋਟੇਸ਼ਨ ਲਈ ਬਜਟ ਬਣਾਓ। ਇਹ ਸੁਮੇਲ ਸ਼ੁਰੂ ਤੋਂ ਬਣਾਉਣ ਨਾਲੋਂ ਤੇਜ਼ੀ ਨਾਲ ਆਉਂਦਾ ਹੈ।