ਏਆਈ, ਬਿਗ ਡੇਟਾ, ਅਤੇ ਮਸ਼ੀਨ ਲਰਨਿੰਗ ਦੁਨੀਆ ਭਰ ਵਿੱਚ ਨੀਤੀ ਨਿਰਮਾਤਾਵਾਂ, ਕਾਰੋਬਾਰਾਂ, ਵਿਗਿਆਨ, ਮੀਡੀਆ ਹਾਊਸਾਂ ਅਤੇ ਕਈ ਤਰ੍ਹਾਂ ਦੇ ਉਦਯੋਗਾਂ ਨੂੰ ਪ੍ਰਭਾਵਿਤ ਕਰਦੇ ਰਹਿੰਦੇ ਹਨ। ਰਿਪੋਰਟਾਂ ਸੁਝਾਅ ਦਿੰਦੀਆਂ ਹਨ ਕਿ 2022 ਵਿੱਚ ਏਆਈ ਦੀ ਵਿਸ਼ਵਵਿਆਪੀ ਗੋਦ ਲੈਣ ਦੀ ਦਰ ਵਰਤਮਾਨ ਵਿੱਚ 35% ਹੈ - ਜੋ ਕਿ 2021 ਤੋਂ 4% ਦਾ ਵੱਡਾ ਵਾਧਾ ਹੈ। ਕਥਿਤ ਤੌਰ 'ਤੇ 42% ਵਾਧੂ ਕੰਪਨੀਆਂ ਆਪਣੇ ਕਾਰੋਬਾਰ ਲਈ ਏਆਈ ਦੇ ਬਹੁਤ ਸਾਰੇ ਲਾਭਾਂ ਦੀ ਪੜਚੋਲ ਕਰ ਰਹੀਆਂ ਹਨ।
ਬਹੁਤ ਸਾਰੀਆਂ AI ਪਹਿਲਕਦਮੀਆਂ ਅਤੇ ਮਸ਼ੀਨ ਲਰਨਿੰਗ ਸਮਾਧਾਨਾਂ ਨੂੰ ਸ਼ਕਤੀ ਪ੍ਰਦਾਨ ਕਰਨ ਵਾਲਾ ਡੇਟਾ ਹੈ। AI ਸਿਰਫ਼ ਐਲਗੋਰਿਦਮ ਨੂੰ ਫੀਡ ਕਰਨ ਵਾਲੇ ਡੇਟਾ ਜਿੰਨਾ ਹੀ ਵਧੀਆ ਹੋ ਸਕਦਾ ਹੈ। ਘੱਟ-ਗੁਣਵੱਤਾ ਵਾਲੇ ਡੇਟਾ ਦੇ ਨਤੀਜੇ ਵਜੋਂ ਘੱਟ-ਗੁਣਵੱਤਾ ਵਾਲੇ ਨਤੀਜੇ ਅਤੇ ਗਲਤ ਭਵਿੱਖਬਾਣੀਆਂ ਹੋ ਸਕਦੀਆਂ ਹਨ।
ਜਦੋਂ ਕਿ ML ਅਤੇ AI ਹੱਲ ਵਿਕਾਸ 'ਤੇ ਬਹੁਤ ਧਿਆਨ ਦਿੱਤਾ ਗਿਆ ਹੈ, ਇੱਕ ਗੁਣਵੱਤਾ ਡੇਟਾਸੈਟ ਦੇ ਤੌਰ 'ਤੇ ਕੀ ਯੋਗਤਾ ਪੂਰੀ ਕਰਦਾ ਹੈ, ਇਸ ਬਾਰੇ ਜਾਗਰੂਕਤਾ ਗਾਇਬ ਹੈ। ਇਸ ਲੇਖ ਵਿੱਚ, ਅਸੀਂ ਗੁਣਵੱਤਾ ਵਾਲੇ AI ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਸਮਾਂ-ਰੇਖਾ ਨੂੰ ਨੈਵੀਗੇਟ ਕਰਦੇ ਹਾਂ ਅਤੇ ਡੇਟਾ ਸੰਗ੍ਰਹਿ ਅਤੇ ਸਿਖਲਾਈ ਦੀ ਸਮਝ ਦੁਆਰਾ AI ਦੇ ਭਵਿੱਖ ਦੀ ਪਛਾਣ ਕਰਦੇ ਹਾਂ।
AI ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਪਰਿਭਾਸ਼ਾ
ਇੱਕ ML ਹੱਲ ਬਣਾਉਂਦੇ ਸਮੇਂ, ਸਿਖਲਾਈ ਡੇਟਾਸੈਟ ਦੀ ਮਾਤਰਾ ਅਤੇ ਗੁਣਵੱਤਾ ਮਾਇਨੇ ਰੱਖਦੀ ਹੈ। ML ਸਿਸਟਮ ਨੂੰ ਨਾ ਸਿਰਫ਼ ਗਤੀਸ਼ੀਲ, ਨਿਰਪੱਖ, ਅਤੇ ਕੀਮਤੀ ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਵੱਡੀ ਮਾਤਰਾ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ, ਸਗੋਂ ਇਸਦੀ ਬਹੁਤ ਜ਼ਿਆਦਾ ਲੋੜ ਹੁੰਦੀ ਹੈ।
ਪਰ ਏਆਈ ਸਿਖਲਾਈ ਡੇਟਾ ਕੀ ਹੈ?
AI ਸਿਖਲਾਈ ਡੇਟਾ ਸਹੀ ਪੂਰਵ-ਅਨੁਮਾਨਾਂ ਕਰਨ ਲਈ ML ਐਲਗੋਰਿਦਮ ਨੂੰ ਸਿਖਲਾਈ ਦੇਣ ਲਈ ਵਰਤੇ ਗਏ ਲੇਬਲ ਕੀਤੇ ਡੇਟਾ ਦਾ ਸੰਗ੍ਰਹਿ ਹੈ। ML ਸਿਸਟਮ ਪੈਟਰਨਾਂ ਨੂੰ ਪਛਾਣਨ ਅਤੇ ਪਛਾਣਨ ਦੀ ਕੋਸ਼ਿਸ਼ ਕਰਦਾ ਹੈ, ਮਾਪਦੰਡਾਂ ਵਿਚਕਾਰ ਸਬੰਧਾਂ ਨੂੰ ਸਮਝਦਾ ਹੈ, ਲੋੜੀਂਦੇ ਫੈਸਲੇ ਲੈਂਦਾ ਹੈ, ਅਤੇ ਸਿਖਲਾਈ ਡੇਟਾ ਦੇ ਆਧਾਰ 'ਤੇ ਮੁਲਾਂਕਣ ਕਰਦਾ ਹੈ।
ਉਦਾਹਰਨ ਲਈ, ਸਵੈ-ਡਰਾਈਵਿੰਗ ਕਾਰਾਂ ਦੀ ਉਦਾਹਰਣ ਲਓ। ਸਵੈ-ਡਰਾਈਵਿੰਗ ML ਮਾਡਲ ਲਈ ਸਿਖਲਾਈ ਡੇਟਾਸੈਟ ਵਿੱਚ ਕਾਰਾਂ, ਪੈਦਲ ਚੱਲਣ ਵਾਲਿਆਂ, ਸੜਕ ਦੇ ਚਿੰਨ੍ਹ ਅਤੇ ਹੋਰ ਵਾਹਨਾਂ ਦੇ ਲੇਬਲ ਕੀਤੇ ਚਿੱਤਰ ਅਤੇ ਵੀਡੀਓ ਸ਼ਾਮਲ ਹੋਣੇ ਚਾਹੀਦੇ ਹਨ।
ਸੰਖੇਪ ਵਿੱਚ, ML ਐਲਗੋਰਿਦਮ ਦੀ ਗੁਣਵੱਤਾ ਨੂੰ ਵਧਾਉਣ ਲਈ, ਤੁਹਾਨੂੰ ਚੰਗੀ ਤਰ੍ਹਾਂ ਸਟ੍ਰਕਚਰਡ, ਐਨੋਟੇਟਿਡ, ਅਤੇ ਲੇਬਲ ਕੀਤੇ ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਵੱਡੀ ਮਾਤਰਾ ਦੀ ਲੋੜ ਹੈ।
ਗੁਣਵੱਤਾ ਸਿਖਲਾਈ ਡੇਟਾ ਅਤੇ ਇਸਦੇ ਵਿਕਾਸ ਦੀ ਮਹੱਤਤਾ
ਉੱਚ-ਗੁਣਵੱਤਾ ਸਿਖਲਾਈ ਡੇਟਾ AI ਅਤੇ ML ਐਪ ਵਿਕਾਸ ਵਿੱਚ ਮੁੱਖ ਇਨਪੁਟ ਹੈ। ਵੱਖ-ਵੱਖ ਸਰੋਤਾਂ ਤੋਂ ਡਾਟਾ ਇਕੱਠਾ ਕੀਤਾ ਜਾਂਦਾ ਹੈ ਅਤੇ ਮਸ਼ੀਨ ਸਿਖਲਾਈ ਦੇ ਉਦੇਸ਼ਾਂ ਲਈ ਅਸੰਗਠਿਤ ਰੂਪ ਵਿੱਚ ਪੇਸ਼ ਕੀਤਾ ਜਾਂਦਾ ਹੈ। ਗੁਣਵੱਤਾ ਸਿਖਲਾਈ ਡੇਟਾ - ਲੇਬਲ ਕੀਤਾ, ਐਨੋਟੇਟ ਕੀਤਾ, ਅਤੇ ਟੈਗ ਕੀਤਾ - ਹਮੇਸ਼ਾ ਇੱਕ ਸੰਗਠਿਤ ਫਾਰਮੈਟ ਵਿੱਚ ਹੁੰਦਾ ਹੈ - ML ਸਿਖਲਾਈ ਲਈ ਆਦਰਸ਼।
ਗੁਣਵੱਤਾ ਸਿਖਲਾਈ ਡੇਟਾ ML ਸਿਸਟਮ ਲਈ ਵਸਤੂਆਂ ਦੀ ਪਛਾਣ ਕਰਨਾ ਅਤੇ ਉਹਨਾਂ ਨੂੰ ਪੂਰਵ-ਨਿਰਧਾਰਤ ਵਿਸ਼ੇਸ਼ਤਾਵਾਂ ਦੇ ਅਨੁਸਾਰ ਸ਼੍ਰੇਣੀਬੱਧ ਕਰਨਾ ਆਸਾਨ ਬਣਾਉਂਦਾ ਹੈ। ਜੇਕਰ ਵਰਗੀਕਰਨ ਸਹੀ ਨਹੀਂ ਹੈ ਤਾਂ ਡੇਟਾਸੈਟ ਮਾੜੇ ਮਾਡਲ ਨਤੀਜੇ ਦੇ ਸਕਦਾ ਹੈ।
ਏਆਈ ਸਿਖਲਾਈ ਡੇਟਾ ਦੇ ਸ਼ੁਰੂਆਤੀ ਦਿਨ
ਮੌਜੂਦਾ ਕਾਰੋਬਾਰ ਅਤੇ ਖੋਜ ਜਗਤ ਵਿੱਚ AI ਦਾ ਦਬਦਬਾ ਹੋਣ ਦੇ ਬਾਵਜੂਦ, ML ਦੇ ਆਰਟੀਫੀਸ਼ੀਅਲ ਇੰਟੈਲੀਜੈਂਸ ਦੇ ਦਬਦਬੇ ਤੋਂ ਪਹਿਲਾਂ ਦੇ ਸ਼ੁਰੂਆਤੀ ਦਿਨ ਕਾਫ਼ੀ ਵੱਖਰੇ ਸਨ।
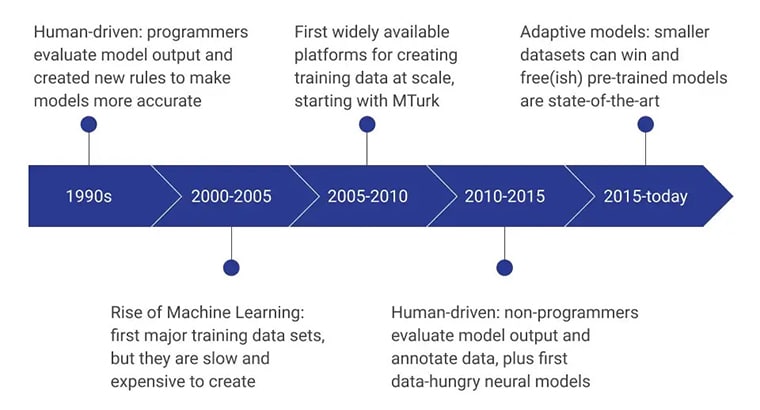
ਅਗਲੇ ਕੁਝ ਸਾਲਾਂ ਵਿੱਚ ਡਾਟਾ ਮਾਡਲਾਂ ਨੂੰ ਬਣਾਉਣ ਅਤੇ ਮੁਲਾਂਕਣ ਕਰਨ ਵਾਲੇ ਗੈਰ-ਪ੍ਰੋਗਰਾਮਰਾਂ 'ਤੇ ਧਿਆਨ ਕੇਂਦਰਿਤ ਕੀਤਾ ਗਿਆ। ਵਰਤਮਾਨ ਵਿੱਚ, ਉੱਨਤ ਸਿਖਲਾਈ ਡੇਟਾ ਇਕੱਠਾ ਕਰਨ ਦੇ ਤਰੀਕਿਆਂ ਦੀ ਵਰਤੋਂ ਕਰਕੇ ਵਿਕਸਿਤ ਕੀਤੇ ਗਏ ਪ੍ਰੀ-ਟ੍ਰੇਂਡ ਮਾਡਲਾਂ 'ਤੇ ਫੋਕਸ ਹੈ।
ਗੁਣਵੱਤਾ ਵੱਧ ਮਾਤਰਾ
ਪੁਰਾਣੇ ਸਮੇਂ ਵਿੱਚ AI ਸਿਖਲਾਈ ਡੇਟਾਸੈਟਾਂ ਦੀ ਇਕਸਾਰਤਾ ਦਾ ਮੁਲਾਂਕਣ ਕਰਦੇ ਸਮੇਂ, ਡੇਟਾ ਵਿਗਿਆਨੀਆਂ ਨੇ ਗੁਣਵੱਤਾ ਨਾਲੋਂ AI ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਮਾਤਰਾ 'ਤੇ ਧਿਆਨ ਕੇਂਦਰਿਤ ਕੀਤਾ।
ਉਦਾਹਰਨ ਲਈ, ਇੱਕ ਆਮ ਗਲਤ ਧਾਰਨਾ ਸੀ ਕਿ ਵੱਡੇ ਡੇਟਾਬੇਸ ਸਹੀ ਨਤੀਜੇ ਪ੍ਰਦਾਨ ਕਰਦੇ ਹਨ। ਡੇਟਾ ਦੀ ਪੂਰੀ ਮਾਤਰਾ ਨੂੰ ਡੇਟਾ ਦੇ ਮੁੱਲ ਦਾ ਇੱਕ ਚੰਗਾ ਸੂਚਕ ਮੰਨਿਆ ਜਾਂਦਾ ਸੀ। ਮਾਤਰਾ ਡੇਟਾਸੈਟ ਦੇ ਮੁੱਲ ਨੂੰ ਨਿਰਧਾਰਤ ਕਰਨ ਵਾਲੇ ਪ੍ਰਾਇਮਰੀ ਕਾਰਕਾਂ ਵਿੱਚੋਂ ਇੱਕ ਹੈ - ਡੇਟਾ ਗੁਣਵੱਤਾ ਦੀ ਭੂਮਿਕਾ ਨੂੰ ਮਾਨਤਾ ਦਿੱਤੀ ਗਈ ਸੀ।
ਇਹ ਜਾਗਰੂਕਤਾ ਵਧੀ ਕਿ ਡੇਟਾ ਦੀ ਗੁਣਵੱਤਾ ਡੇਟਾ ਦੀ ਸੰਪੂਰਨਤਾ, ਭਰੋਸੇਯੋਗਤਾ, ਵੈਧਤਾ, ਉਪਲਬਧਤਾ ਅਤੇ ਸਮਾਂਬੱਧਤਾ 'ਤੇ ਨਿਰਭਰ ਕਰਦੀ ਹੈ। ਸਭ ਤੋਂ ਮਹੱਤਵਪੂਰਨ ਗੱਲ ਇਹ ਹੈ ਕਿ ਪ੍ਰੋਜੈਕਟ ਲਈ ਡੇਟਾ ਅਨੁਕੂਲਤਾ ਨੇ ਇਕੱਤਰ ਕੀਤੇ ਡੇਟਾ ਦੀ ਗੁਣਵੱਤਾ ਨੂੰ ਨਿਰਧਾਰਤ ਕੀਤਾ।
ਮਾੜੇ ਸਿਖਲਾਈ ਡੇਟਾ ਦੇ ਕਾਰਨ ਸ਼ੁਰੂਆਤੀ AI ਪ੍ਰਣਾਲੀਆਂ ਦੀਆਂ ਸੀਮਾਵਾਂ
ਮਾੜਾ ਸਿਖਲਾਈ ਡੇਟਾ, ਤਕਨੀਕੀ ਕੰਪਿਊਟਿੰਗ ਪ੍ਰਣਾਲੀਆਂ ਦੀ ਘਾਟ ਦੇ ਨਾਲ, ਸ਼ੁਰੂਆਤੀ AI ਪ੍ਰਣਾਲੀਆਂ ਦੇ ਕਈ ਅਧੂਰੇ ਵਾਅਦਿਆਂ ਦਾ ਇੱਕ ਕਾਰਨ ਸੀ।
ਗੁਣਵੱਤਾ ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਘਾਟ ਕਾਰਨ, ML ਹੱਲ ਨਿਊਰਲ ਖੋਜ ਦੇ ਵਿਕਾਸ ਨੂੰ ਰੋਕਣ ਵਾਲੇ ਵਿਜ਼ੂਅਲ ਪੈਟਰਨਾਂ ਦੀ ਸਹੀ ਪਛਾਣ ਨਹੀਂ ਕਰ ਸਕੇ। ਹਾਲਾਂਕਿ ਬਹੁਤ ਸਾਰੇ ਖੋਜਕਰਤਾਵਾਂ ਨੇ ਬੋਲੀ ਜਾਣ ਵਾਲੀ ਭਾਸ਼ਾ ਦੀ ਮਾਨਤਾ ਦੇ ਵਾਅਦੇ ਦੀ ਪਛਾਣ ਕੀਤੀ ਹੈ, ਬੋਲੀ ਦੀ ਪਛਾਣ ਕਰਨ ਵਾਲੇ ਸਾਧਨਾਂ ਦੀ ਖੋਜ ਜਾਂ ਵਿਕਾਸ ਭਾਸ਼ਣ ਡੇਟਾਸੈਟਾਂ ਦੀ ਘਾਟ ਕਾਰਨ ਪੂਰਾ ਨਹੀਂ ਹੋ ਸਕਿਆ। ਉੱਚ-ਅੰਤ ਦੇ AI ਟੂਲਸ ਨੂੰ ਵਿਕਸਤ ਕਰਨ ਵਿੱਚ ਇੱਕ ਹੋਰ ਵੱਡੀ ਰੁਕਾਵਟ ਕੰਪਿਊਟਰਾਂ ਦੀ ਗਣਨਾਤਮਕ ਅਤੇ ਸਟੋਰੇਜ ਸਮਰੱਥਾਵਾਂ ਦੀ ਘਾਟ ਸੀ।
ਕੁਆਲਿਟੀ ਟਰੇਨਿੰਗ ਡੇਟਾ ਵਿੱਚ ਸ਼ਿਫਟ
ਇਸ ਜਾਗਰੂਕਤਾ ਵਿੱਚ ਇੱਕ ਸਪਸ਼ਟ ਤਬਦੀਲੀ ਆਈ ਹੈ ਕਿ ਡੇਟਾਸੈਟ ਦੀ ਗੁਣਵੱਤਾ ਮਹੱਤਵਪੂਰਨ ਹੈ। ML ਸਿਸਟਮ ਲਈ ਮਨੁੱਖੀ ਬੁੱਧੀ ਅਤੇ ਫੈਸਲੇ ਲੈਣ ਦੀਆਂ ਸਮਰੱਥਾਵਾਂ ਦੀ ਸਹੀ ਨਕਲ ਕਰਨ ਲਈ, ਇਸ ਨੂੰ ਉੱਚ-ਆਵਾਜ਼, ਉੱਚ-ਗੁਣਵੱਤਾ ਸਿਖਲਾਈ ਡੇਟਾ 'ਤੇ ਪ੍ਰਫੁੱਲਤ ਕਰਨਾ ਪੈਂਦਾ ਹੈ।
ਆਪਣੇ ML ਡੇਟਾ ਨੂੰ ਇੱਕ ਸਰਵੇਖਣ ਵਾਂਗ ਸੋਚੋ - ਡੇਟਾ ਨਮੂਨੇ ਦਾ ਆਕਾਰ ਜਿੰਨਾ ਵੱਡਾ ਹੋਵੇਗਾ, ਭਵਿੱਖਬਾਣੀ ਓਨੀ ਹੀ ਬਿਹਤਰ ਹੋਵੇਗੀ। ਜੇਕਰ ਨਮੂਨਾ ਡੇਟਾ ਵਿੱਚ ਸਾਰੇ ਵੇਰੀਏਬਲ ਸ਼ਾਮਲ ਨਹੀਂ ਹਨ, ਤਾਂ ਇਹ ਪੈਟਰਨਾਂ ਨੂੰ ਪਛਾਣ ਨਹੀਂ ਸਕਦਾ ਜਾਂ ਗਲਤ ਸਿੱਟੇ ਨਹੀਂ ਲਿਆ ਸਕਦਾ।
AI ਤਕਨਾਲੋਜੀ ਵਿੱਚ ਤਰੱਕੀ ਅਤੇ ਬਿਹਤਰ ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਲੋੜ

ਇਹ ਸਮਝ ਕਿ ਬਿਹਤਰ ਸਿਖਲਾਈ ਡੇਟਾ ਭਰੋਸੇਮੰਦ ML ਮਾਡਲਾਂ ਦੀ ਸੰਭਾਵਨਾ ਨੂੰ ਵਧਾਉਂਦਾ ਹੈ, ਨੇ ਬਿਹਤਰ ਡੇਟਾ ਸੰਗ੍ਰਹਿ, ਐਨੋਟੇਸ਼ਨ, ਅਤੇ ਲੇਬਲਿੰਗ ਵਿਧੀਆਂ ਨੂੰ ਜਨਮ ਦਿੱਤਾ। ਡੇਟਾ ਦੀ ਗੁਣਵੱਤਾ ਅਤੇ ਪ੍ਰਸੰਗਿਕਤਾ ਨੇ ਸਿੱਧੇ ਤੌਰ 'ਤੇ AI ਮਾਡਲ ਦੀ ਗੁਣਵੱਤਾ ਨੂੰ ਪ੍ਰਭਾਵਿਤ ਕੀਤਾ।

ਡਾਟਾ ਗੁਣਵੱਤਾ ਅਤੇ ਸ਼ੁੱਧਤਾ 'ਤੇ ਫੋਕਸ ਵਧਾਇਆ ਗਿਆ ਹੈ
ML ਮਾਡਲ ਲਈ ਸਹੀ ਨਤੀਜੇ ਪ੍ਰਦਾਨ ਕਰਨਾ ਸ਼ੁਰੂ ਕਰਨ ਲਈ, ਇਸ ਨੂੰ ਗੁਣਵੱਤਾ ਵਾਲੇ ਡੇਟਾਸੇਟਾਂ 'ਤੇ ਖੁਆਇਆ ਜਾਂਦਾ ਹੈ ਜੋ ਦੁਹਰਾਉਣ ਵਾਲੇ ਡੇਟਾ ਰਿਫਾਈਨਿੰਗ ਕਦਮਾਂ ਵਿੱਚੋਂ ਲੰਘਦੇ ਹਨ।
ਉਦਾਹਰਨ ਲਈ, ਇੱਕ ਮਨੁੱਖ ਕੁੱਤੇ ਦੀ ਇੱਕ ਖਾਸ ਨਸਲ ਨੂੰ ਕੁੱਤੇ ਨਾਲ ਜਾਣ-ਪਛਾਣ ਦੇ ਕੁਝ ਦਿਨਾਂ ਦੇ ਅੰਦਰ-ਅੰਦਰ ਤਸਵੀਰਾਂ, ਵੀਡੀਓ, ਜਾਂ ਵਿਅਕਤੀਗਤ ਰੂਪ ਵਿੱਚ ਪਛਾਣਨ ਦੇ ਯੋਗ ਹੋ ਸਕਦਾ ਹੈ। ਲੋੜ ਪੈਣ 'ਤੇ ਇਸ ਗਿਆਨ ਨੂੰ ਯਾਦ ਕਰਨ ਅਤੇ ਖਿੱਚਣ ਲਈ ਮਨੁੱਖ ਆਪਣੇ ਅਨੁਭਵ ਅਤੇ ਸੰਬੰਧਿਤ ਜਾਣਕਾਰੀ ਤੋਂ ਖਿੱਚਦਾ ਹੈ। ਫਿਰ ਵੀ, ਇਹ ਮਸ਼ੀਨ ਲਈ ਆਸਾਨੀ ਨਾਲ ਕੰਮ ਨਹੀਂ ਕਰਦਾ. ਮਸ਼ੀਨ ਨੂੰ ਸਪਸ਼ਟ ਤੌਰ 'ਤੇ ਐਨੋਟੇਟ ਕੀਤੇ ਅਤੇ ਲੇਬਲ ਕੀਤੇ ਚਿੱਤਰਾਂ ਨਾਲ ਖੁਆਇਆ ਜਾਣਾ ਚਾਹੀਦਾ ਹੈ - ਸੈਂਕੜੇ ਜਾਂ ਹਜ਼ਾਰਾਂ - ਉਸ ਖਾਸ ਨਸਲ ਅਤੇ ਹੋਰ ਨਸਲਾਂ ਦੇ ਨਾਲ ਕੁਨੈਕਸ਼ਨ ਬਣਾਉਣ ਲਈ।
ਇੱਕ AI ਮਾਡਲ ਸਿਖਲਾਈ ਪ੍ਰਾਪਤ ਜਾਣਕਾਰੀ ਨੂੰ ਅਸਲ ਦੁਨੀਆਂ ਵਿੱਚ ਪੇਸ਼ ਕੀਤੀ ਗਈ ਜਾਣਕਾਰੀ ਨਾਲ ਜੋੜ ਕੇ ਨਤੀਜੇ ਦੀ ਭਵਿੱਖਬਾਣੀ ਕਰਦਾ ਹੈ । ਜੇਕਰ ਸਿਖਲਾਈ ਡੇਟਾ ਵਿੱਚ ਸੰਬੰਧਿਤ ਜਾਣਕਾਰੀ ਸ਼ਾਮਲ ਨਹੀਂ ਹੈ ਤਾਂ ਐਲਗੋਰਿਦਮ ਬੇਕਾਰ ਹੋ ਜਾਂਦਾ ਹੈ।
ਵਿਭਿੰਨ ਅਤੇ ਪ੍ਰਤੀਨਿਧ ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਮਹੱਤਤਾ
ਇੱਕ ਡੇਟਾਸੈਟ ਇੱਕ ਖਾਸ ਆਬਾਦੀ, ਨਸਲ, ਲਿੰਗ, ਚੋਣ, ਅਤੇ ਬੌਧਿਕ ਵਿਚਾਰਾਂ ਪ੍ਰਤੀ ਪੱਖਪਾਤੀ ਹੋ ਸਕਦਾ ਹੈ, ਜਿਸ ਨਾਲ ਇੱਕ ਗਲਤ ਮਾਡਲ ਹੋ ਸਕਦਾ ਹੈ।
ਇਹ ਯਕੀਨੀ ਬਣਾਉਣਾ ਮਹੱਤਵਪੂਰਨ ਹੈ ਕਿ ਸਾਰਾ ਡਾਟਾ ਇਕੱਠਾ ਕਰਨ ਦੀ ਪ੍ਰਕਿਰਿਆ ਦਾ ਪ੍ਰਵਾਹ, ਜਿਸ ਵਿੱਚ ਵਿਸ਼ਾ ਪੂਲ ਦੀ ਚੋਣ, ਕਿਊਰੇਸ਼ਨ, ਐਨੋਟੇਸ਼ਨ ਅਤੇ ਲੇਬਲਿੰਗ ਸ਼ਾਮਲ ਹੈ, ਕਾਫ਼ੀ ਵਿਭਿੰਨ, ਸੰਤੁਲਿਤ ਅਤੇ ਆਬਾਦੀ ਦਾ ਪ੍ਰਤੀਨਿਧ ਹੈ।

ਏਆਈ ਸਿਖਲਾਈ ਡੇਟਾ ਦਾ ਭਵਿੱਖ
AI ਮਾਡਲਾਂ ਦੀ ਭਵਿੱਖੀ ਸਫਲਤਾ ML ਐਲਗੋਰਿਦਮ ਨੂੰ ਸਿਖਲਾਈ ਦੇਣ ਲਈ ਵਰਤੇ ਗਏ ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਗੁਣਵੱਤਾ ਅਤੇ ਮਾਤਰਾ 'ਤੇ ਨਿਰਭਰ ਕਰਦੀ ਹੈ। ਇਹ ਪਛਾਣਨਾ ਮਹੱਤਵਪੂਰਨ ਹੈ ਕਿ ਡੇਟਾ ਗੁਣਵੱਤਾ ਅਤੇ ਮਾਤਰਾ ਵਿਚਕਾਰ ਇਹ ਸਬੰਧ ਕਾਰਜ-ਵਿਸ਼ੇਸ਼ ਹੈ ਅਤੇ ਇਸਦਾ ਕੋਈ ਨਿਸ਼ਚਿਤ ਜਵਾਬ ਨਹੀਂ ਹੈ।
ਅੰਤ ਵਿੱਚ, ਇੱਕ ਸਿਖਲਾਈ ਡੇਟਾ ਸੈੱਟ ਦੀ ਯੋਗਤਾ ਨੂੰ ਇਸ ਦੁਆਰਾ ਬਣਾਏ ਗਏ ਉਦੇਸ਼ ਲਈ ਭਰੋਸੇਯੋਗਤਾ ਨਾਲ ਵਧੀਆ ਪ੍ਰਦਰਸ਼ਨ ਕਰਨ ਦੀ ਯੋਗਤਾ ਦੁਆਰਾ ਪਰਿਭਾਸ਼ਿਤ ਕੀਤਾ ਜਾਂਦਾ ਹੈ।
ਡਾਟਾ ਇਕੱਤਰ ਕਰਨ ਅਤੇ ਐਨੋਟੇਸ਼ਨ ਤਕਨੀਕਾਂ ਵਿੱਚ ਤਰੱਕੀ
ਕਿਉਂਕਿ ਐੱਮ.ਐੱਲ. ਫੈੱਡ ਡੇਟਾ ਪ੍ਰਤੀ ਸੰਵੇਦਨਸ਼ੀਲ ਹੈ, ਇਸ ਲਈ ਡਾਟਾ ਇਕੱਠਾ ਕਰਨ ਅਤੇ ਐਨੋਟੇਸ਼ਨ ਨੀਤੀਆਂ ਨੂੰ ਸੁਚਾਰੂ ਬਣਾਉਣ ਲਈ ਇਹ ਜ਼ਰੂਰੀ ਹੈ। ਡਾਟਾ ਇਕੱਠਾ ਕਰਨ, ਕਿਊਰੇਸ਼ਨ, ਗਲਤ ਪੇਸ਼ਕਾਰੀ, ਅਧੂਰੇ ਮਾਪ, ਗਲਤ ਸਮੱਗਰੀ, ਡਾਟਾ ਡੁਪਲੀਕੇਸ਼ਨ, ਅਤੇ ਗਲਤ ਮਾਪਾਂ ਵਿੱਚ ਗਲਤੀਆਂ ਨਾਕਾਫ਼ੀ ਡਾਟਾ ਗੁਣਵੱਤਾ ਵਿੱਚ ਯੋਗਦਾਨ ਪਾਉਂਦੀਆਂ ਹਨ।
ਡੇਟਾ ਮਾਈਨਿੰਗ, ਵੈਬ ਸਕ੍ਰੈਪਿੰਗ, ਅਤੇ ਡੇਟਾ ਐਕਸਟਰੈਕਸ਼ਨ ਦੁਆਰਾ ਸਵੈਚਲਿਤ ਡੇਟਾ ਇਕੱਠਾ ਕਰਨਾ ਤੇਜ਼ੀ ਨਾਲ ਡੇਟਾ ਉਤਪਾਦਨ ਲਈ ਰਾਹ ਪੱਧਰਾ ਕਰ ਰਿਹਾ ਹੈ। ਇਸ ਤੋਂ ਇਲਾਵਾ, ਪੂਰਵ-ਪੈਕ ਕੀਤੇ ਡੇਟਾਸੇਟ ਇੱਕ ਤੇਜ਼-ਫਿਕਸ ਡੇਟਾ ਇਕੱਤਰ ਕਰਨ ਦੀ ਤਕਨੀਕ ਵਜੋਂ ਕੰਮ ਕਰਦੇ ਹਨ।
ਕਰਾਊਡਸੋਰਸਿੰਗ ਡੇਟਾ ਇਕੱਠਾ ਕਰਨ ਦਾ ਇੱਕ ਹੋਰ ਵਿਲੱਖਣ ਤਰੀਕਾ ਹੈ। ਜਦੋਂ ਕਿ ਡੇਟਾ ਦੀ ਸੱਚਾਈ ਦੀ ਪੁਸ਼ਟੀ ਨਹੀਂ ਕੀਤੀ ਜਾ ਸਕਦੀ, ਇਹ ਜਨਤਕ ਚਿੱਤਰ ਇਕੱਠਾ ਕਰਨ ਲਈ ਇੱਕ ਵਧੀਆ ਸਾਧਨ ਹੈ। ਅੰਤ ਵਿੱਚ, ਵਿਸ਼ੇਸ਼ ਡੇਟਾ ਇਕੱਠਾ ਕਰਨ ਦੇ ਮਾਹਰ ਖਾਸ ਉਦੇਸ਼ਾਂ ਲਈ ਪ੍ਰਾਪਤ ਡੇਟਾ ਵੀ ਪ੍ਰਦਾਨ ਕਰਦੇ ਹਨ।
ਸਿਖਲਾਈ ਡੇਟਾ ਵਿੱਚ ਨੈਤਿਕ ਵਿਚਾਰਾਂ 'ਤੇ ਜ਼ੋਰ ਦਿੱਤਾ ਗਿਆ
ਕਿਉਂਕਿ ਡੇਟਾ ਵਿੱਚ ਹੁਣ ਚਿਹਰੇ ਦੀਆਂ ਤਸਵੀਰਾਂ, ਫਿੰਗਰਪ੍ਰਿੰਟਸ, ਵੌਇਸ ਰਿਕਾਰਡਿੰਗਾਂ, ਅਤੇ ਹੋਰ ਨਾਜ਼ੁਕ ਬਾਇਓਮੀਟ੍ਰਿਕ ਡੇਟਾ ਤੱਕ ਸਭ ਕੁਝ ਸ਼ਾਮਲ ਹੈ, ਇਸ ਲਈ ਮਹਿੰਗੇ ਮੁਕੱਦਮਿਆਂ ਅਤੇ ਵੱਕਾਰ ਨੂੰ ਨੁਕਸਾਨ ਤੋਂ ਬਚਣ ਲਈ ਕਾਨੂੰਨੀ ਅਤੇ ਨੈਤਿਕ ਅਭਿਆਸਾਂ ਦੀ ਪਾਲਣਾ ਨੂੰ ਯਕੀਨੀ ਬਣਾਉਣਾ ਬਹੁਤ ਮਹੱਤਵਪੂਰਨ ਹੋ ਰਿਹਾ ਹੈ।
ਭਵਿੱਖ ਵਿੱਚ ਹੋਰ ਵੀ ਬਿਹਤਰ ਗੁਣਵੱਤਾ ਅਤੇ ਵਿਭਿੰਨ ਸਿਖਲਾਈ ਡੇਟਾ ਦੀ ਸੰਭਾਵਨਾ
ਭਵਿੱਖ ਵਿੱਚ ਉੱਚ-ਗੁਣਵੱਤਾ ਅਤੇ ਵਿਭਿੰਨ ਸਿਖਲਾਈ ਡੇਟਾ ਲਈ ਇੱਕ ਵੱਡੀ ਸੰਭਾਵਨਾ ਹੈ । ਡੇਟਾ ਗੁਣਵੱਤਾ ਪ੍ਰਤੀ ਜਾਗਰੂਕਤਾ ਅਤੇ ਡੇਟਾ ਪ੍ਰਦਾਤਾਵਾਂ ਦੀ ਉਪਲਬਧਤਾ ਲਈ ਧੰਨਵਾਦ ਜੋ AI ਹੱਲਾਂ ਦੀਆਂ ਗੁਣਵੱਤਾ ਦੀਆਂ ਮੰਗਾਂ ਨੂੰ ਪੂਰਾ ਕਰਦੇ ਹਨ।
ਮੌਜੂਦਾ ਡਾਟਾ ਪ੍ਰਦਾਤਾ ਨੈਤਿਕ ਤੌਰ 'ਤੇ ਅਤੇ ਕਾਨੂੰਨੀ ਤੌਰ 'ਤੇ ਵਿਭਿੰਨ ਡੇਟਾਸੈਟਾਂ ਦੀ ਵੱਡੀ ਮਾਤਰਾ ਨੂੰ ਸਰੋਤ ਬਣਾਉਣ ਲਈ ਬੁਨਿਆਦੀ ਤਕਨੀਕਾਂ ਦੀ ਵਰਤੋਂ ਕਰਨ ਵਿੱਚ ਮਾਹਰ ਹਨ। ਉਹਨਾਂ ਕੋਲ ਵੱਖ-ਵੱਖ ML ਪ੍ਰੋਜੈਕਟਾਂ ਲਈ ਅਨੁਕੂਲਿਤ ਡੇਟਾ ਨੂੰ ਲੇਬਲ, ਐਨੋਟੇਟ ਅਤੇ ਪੇਸ਼ ਕਰਨ ਲਈ ਅੰਦਰੂਨੀ ਟੀਮਾਂ ਵੀ ਹਨ।

ਸਿੱਟਾ
ਉੱਚ-ਅੰਤ ਵਾਲੇ AI ਮਾਡਲਾਂ ਨੂੰ ਵਿਕਸਤ ਕਰਨ ਲਈ ਡੇਟਾ ਅਤੇ ਗੁਣਵੱਤਾ ਦੀ ਡੂੰਘੀ ਸਮਝ ਵਾਲੇ ਭਰੋਸੇਯੋਗ ਵਿਕਰੇਤਾਵਾਂ ਨਾਲ ਭਾਈਵਾਲੀ ਕਰਨਾ ਮਹੱਤਵਪੂਰਨ ਹੈ । ਸ਼ੇਪ ਇੱਕ ਪ੍ਰਮੁੱਖ ਐਨੋਟੇਸ਼ਨ ਕੰਪਨੀ ਹੈ ਜੋ ਤੁਹਾਡੀਆਂ AI ਪ੍ਰੋਜੈਕਟ ਜ਼ਰੂਰਤਾਂ ਅਤੇ ਟੀਚਿਆਂ ਨੂੰ ਪੂਰਾ ਕਰਨ ਵਾਲੇ ਅਨੁਕੂਲਿਤ ਡੇਟਾ ਹੱਲ ਪ੍ਰਦਾਨ ਕਰਨ ਵਿੱਚ ਮਾਹਰ ਹੈ। ਸਾਡੇ ਨਾਲ ਭਾਈਵਾਲੀ ਕਰੋ ਅਤੇ ਸਾਡੇ ਦੁਆਰਾ ਲਿਆਏ ਗਏ ਯੋਗਤਾਵਾਂ, ਵਚਨਬੱਧਤਾ ਅਤੇ ਸਹਿਯੋਗ ਦੀ ਪੜਚੋਲ ਕਰੋ।