ਕਲਪਨਾ ਕਰੋ ਕਿ ਤੁਸੀਂ ਇੱਕ ਵੌਇਸ ਅਸਿਸਟੈਂਟ ਨੂੰ ਇੱਕ ਲੰਬੀ ਮੀਟਿੰਗ ਦਾ ਸਾਰ ਦੇਣ, ਇਸਦਾ ਸਪੈਨਿਸ਼ ਵਿੱਚ ਅਨੁਵਾਦ ਕਰਨ, ਅਤੇ ਐਕਸ਼ਨ ਆਈਟਮਾਂ ਨੂੰ ਆਪਣੇ CRM ਵਿੱਚ ਭੇਜਣ ਲਈ ਕਹਿ ਰਹੇ ਹੋ - ਇਹ ਸਭ ਇੱਕ ਸਿੰਗਲ ਵੌਇਸ ਨੋਟ ਤੋਂ ।
ਉਸ "ਜਾਦੂ" ਦੇ ਪਿੱਛੇ ਸਿਰਫ਼ ਵਿਸਪਰ ਵਰਗਾ ਇੱਕ ਸ਼ਕਤੀਸ਼ਾਲੀ ਮਾਡਲ ਜਾਂ ਜੈਮਿਨੀ ਜਾਂ ਚੈਟਜੀਪੀਟੀ ਵਰਗਾ ਇੱਕ ਐਲਐਲਐਮ ਨਹੀਂ ਹੈ। ਇਹ ਉਹਨਾਂ ਮਾਡਲਾਂ ਨੂੰ ਸਿਖਲਾਈ ਦੇਣ ਅਤੇ ਵਧੀਆ-ਟਿਊਨ ਕਰਨ ਲਈ ਵਰਤੇ ਜਾਂਦੇ ਸਪੀਚ ਪਛਾਣ ਡੇਟਾਸੈੱਟ ਹਨ।
2025 ਵਿੱਚ, ਬੋਲੀ ਅਤੇ ਆਵਾਜ਼ ਦੀ ਪਛਾਣ ਇੱਕ ਬਹੁ-ਅਰਬ ਡਾਲਰ ਦਾ ਬਾਜ਼ਾਰ ਹੈ, ਜਿਸਦੇ 2032 ਤੱਕ $80 ਬਿਲੀਅਨ ਤੋਂ ਵੱਧ ਹੋਣ ਦਾ ਅਨੁਮਾਨ ਹੈ ।
ਜੇਕਰ ਤੁਹਾਡਾ AI ਉਤਪਾਦ ਸਪੋਕਨ ਇਨਪੁੱਟ 'ਤੇ ਨਿਰਭਰ ਕਰਦਾ ਹੈ - ਭਾਵੇਂ ਉਹ ਸੰਪਰਕ ਕੇਂਦਰ ਕਾਲਾਂ, ਡਿਕਟੇਸ਼ਨ, ਜਾਂ ਵੌਇਸ ਖੋਜ ਹੋਵੇ - ਤੁਹਾਡੇ ਸਪੀਚ ਡੇਟਾਸੈਟਾਂ ਦੀ ਗੁਣਵੱਤਾ, ਵਿਭਿੰਨਤਾ ਅਤੇ ਕਾਨੂੰਨੀਤਾ ਇਹ ਨਿਰਧਾਰਤ ਕਰੇਗੀ ਕਿ ਤੁਹਾਡਾ AI ਕਿੰਨੀ ਚੰਗੀ ਤਰ੍ਹਾਂ "ਸੁਣਦਾ" ਹੈ।
ਇਸ ਲੇਖ ਵਿੱਚ, ਅਸੀਂ ਵਿਭਿੰਨ ਬੋਲੀ ਮਾਨਤਾ ਡੇਟਾਸੈਟਾਂ ਬਾਰੇ ਗੱਲ ਕਰਾਂਗੇ। ਤੁਹਾਡੇ AI ਮਾਡਲ ਲਈ ਸਭ ਤੋਂ ਵਧੀਆ ਡਾਟਾਸੈੱਟ ਚੁਣਨ ਵਿੱਚ ਤੁਹਾਡੀ ਮਦਦ ਕਰਨ ਲਈ ਅਸੀਂ ਉਹਨਾਂ ਦੀਆਂ ਕਿਸਮਾਂ ਦੀ ਪੜਚੋਲ ਕਰਾਂਗੇ।
ਪਰ ਪਹਿਲਾਂ, ਆਓ ਕੁਝ ਬੁਨਿਆਦੀ ਗੱਲਾਂ ਵਿੱਚ ਜਾਣੀਏ।
ਇੱਕ ਬੋਲੀ ਪਛਾਣ ਡੇਟਾਸੈਟ ਕੀ ਹੈ?
ਉਦਾਹਰਨ ਲਈ, ਟੈਕਸਾਸ ਦਾ ਇੱਕ ਵਿਅਕਤੀ ਲੰਡਨ ਵਿੱਚ ਕਿਸੇ ਵਿਅਕਤੀ ਤੋਂ ਵੱਖਰਾ ਲੱਗਦਾ ਹੈ, ਭਾਵੇਂ ਉਹ ਇੱਕੋ ਵਾਕ ਬੋਲਦਾ ਹੋਵੇ। ਇੱਕ ਚੰਗਾ ਡੇਟਾਸੈਟ ਇਸ ਵਿਭਿੰਨਤਾ ਨੂੰ ਹਾਸਲ ਕਰਦਾ ਹੈ। ਇਹ AI ਨੂੰ ਮਨੁੱਖੀ ਭਾਸ਼ਣ ਦੀਆਂ ਬਾਰੀਕੀਆਂ ਨੂੰ ਸੁਣਨ ਅਤੇ ਸਮਝਣ ਵਿੱਚ ਮਦਦ ਕਰਦਾ ਹੈ।
ਇਹ ਡੇਟਾਸੈਟ AI ਮਾਡਲਾਂ ਨੂੰ ਵਿਕਸਤ ਕਰਨ ਵਿੱਚ ਇੱਕ ਮਹੱਤਵਪੂਰਨ ਭੂਮਿਕਾ ਨਿਭਾਉਂਦਾ ਹੈ। ਇਹ AI ਨੂੰ ਭਾਸ਼ਾ ਦੀ ਸਮਝ ਅਤੇ ਉਤਪਾਦਨ ਸਿੱਖਣ ਲਈ ਜ਼ਰੂਰੀ ਡਾਟਾ ਪ੍ਰਦਾਨ ਕਰਦਾ ਹੈ। ਇੱਕ ਅਮੀਰ ਅਤੇ ਵਿਭਿੰਨ ਡੇਟਾਸੈਟ ਦੇ ਨਾਲ, ਇੱਕ AI ਮਾਡਲ ਮਨੁੱਖੀ ਭਾਸ਼ਾ ਨੂੰ ਸਮਝਣ ਅਤੇ ਉਸ ਨਾਲ ਗੱਲਬਾਤ ਕਰਨ ਵਿੱਚ ਵਧੇਰੇ ਸਮਰੱਥ ਬਣ ਜਾਂਦਾ ਹੈ। ਇਸਲਈ, ਇੱਕ ਸਪੀਚ ਰਿਕੋਗਨੀਸ਼ਨ ਡੇਟਾਸੈਟ ਤੁਹਾਨੂੰ ਬੁੱਧੀਮਾਨ, ਜਵਾਬਦੇਹ, ਅਤੇ ਸਟੀਕ ਵੌਇਸ ਏਆਈ ਮਾਡਲ ਬਣਾਉਣ ਵਿੱਚ ਮਦਦ ਕਰ ਸਕਦਾ ਹੈ।
ਤੁਹਾਨੂੰ ਕੁਆਲਿਟੀ ਸਪੀਚ ਰਿਕੋਗਨੀਸ਼ਨ ਡੇਟਾਸੈਟ ਦੀ ਲੋੜ ਕਿਉਂ ਹੈ?
ਸਪੀਚ-ਨੇਟਿਵ LLM ਦੇ ਉਭਾਰ ਦੇ ਨਾਲ, ਨਵੇਂ ਡੇਟਾਸੈੱਟ ਕਿਸਮਾਂ ਉਭਰ ਰਹੀਆਂ ਹਨ:
- ਕੁਦਰਤੀ ਭਾਸ਼ਾ ਦੇ ਵਰਣਨ (ਜਿਵੇਂ ਕਿ ਸਪੀਚਕਰਾਫਟ) ਦੇ ਨਾਲ ਭਾਵਪੂਰਨ ਭਾਸ਼ਣ - ਸਿਖਲਾਈ ਮਾਡਲਾਂ ਦਾ ਸਮਰਥਨ ਕਰਦਾ ਹੈ ਜੋ ਸ਼ੈਲੀ, ਭਾਵਨਾ ਅਤੇ ਛੰਦ ਨੂੰ ਸਮਝਦੇ ਹਨ।
- ਅਸਲ ਡੇਟਾ ਨੂੰ ਵਧਾਉਣ ਲਈ TTS + LLM-ਤਿਆਰ ਕੀਤੇ ਟੈਕਸਟ (ਜਿਵੇਂ ਕਿ, ਮੈਗਪੀ ਸਪੀਚ) ਨਾਲ ਬਣਾਇਆ ਗਿਆ ਸਿੰਥੈਟਿਕ ਸਪੀਚ ਕਾਰਪੋਰਾ।
- ਵੌਇਸ ਸੁਰੱਖਿਆ ਅਤੇ ਧੋਖਾਧੜੀ ਦਾ ਪਤਾ ਲਗਾਉਣ ਲਈ ਨਕਲੀ ਭਾਸ਼ਣ / ਸਪੂਫ ਖੋਜ ਡੇਟਾਸੈੱਟ (ਜਿਵੇਂ ਕਿ, LlamaPartialSpoof)।
ਜਦੋਂ ਵਰਤੋਂ: ਤੁਸੀਂ ਸਪੀਚ-ਲੈਂਗਵੇਜ ਮਾਡਲਾਂ, ਐਕਸਪ੍ਰੈਸਿਵ ਟੀਟੀਐਸ, ਜਾਂ ਏਆਈ ਸੁਰੱਖਿਆ/ਧੋਖਾਧੜੀ ਖੋਜ 'ਤੇ ਕੰਮ ਕਰ ਰਹੇ ਹੋ।
ਸਹੀ ਸਪੀਚ ਰਿਕੋਗਨੀਸ਼ਨ ਡੇਟਾਸੈੱਟ ਕਿਵੇਂ ਚੁਣਨਾ ਹੈ (ਕਦਮ-ਦਰ-ਕਦਮ)
ਇਸਨੂੰ ਇੱਕ ਵਿਹਾਰਕ ਫੈਸਲੇ ਦੇ ਢਾਂਚੇ ਵਜੋਂ ਵਰਤੋ।
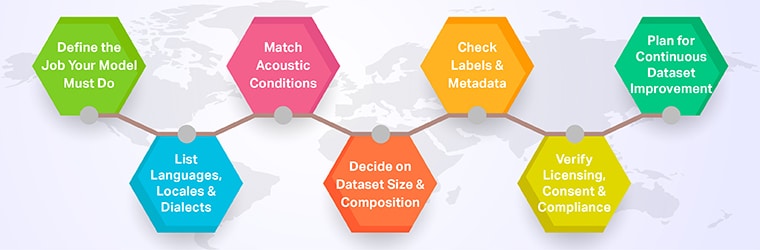
ਕਦਮ 1 - ਉਸ ਕੰਮ ਨੂੰ ਪਰਿਭਾਸ਼ਿਤ ਕਰੋ ਜੋ ਤੁਹਾਡੇ ਮਾਡਲ ਨੂੰ ਕਰਨਾ ਚਾਹੀਦਾ ਹੈ।
- ਕੰਮ: ਡਿਕਟੇਸ਼ਨ, ਵੌਇਸ ਖੋਜ, ਸੰਪਰਕ ਕੇਂਦਰ ਵਿਸ਼ਲੇਸ਼ਣ, ਰੀਅਲ-ਟਾਈਮ ਕੈਪਸ਼ਨ, ਪਾਲਣਾ ਨਿਗਰਾਨੀ, ਆਦਿ।
- ਚੈਨਲ: ਟੈਲੀਫੋਨੀ (8 kHz), ਮੋਬਾਈਲ ਐਪ, ਦੂਰ-ਖੇਤਰ ਦੇ ਸਮਾਰਟ ਸਪੀਕਰ, ਕਾਰ ਵਿੱਚ ਮਾਈਕ੍ਰੋਫ਼ੋਨ।
- ਕੁਆਲਿਟੀ ਬਾਰ: ਟੀਚਾ WER, ਲੇਟੈਂਸੀ, ਜਵਾਬ ਸਮਾਂ, ਰੈਗੂਲੇਟਰੀ ਜ਼ਰੂਰਤਾਂ।
ਕਦਮ 2 – ਭਾਸ਼ਾਵਾਂ, ਸਥਾਨਾਂ ਅਤੇ ਉਪਭਾਸ਼ਾਵਾਂ ਦੀ ਸੂਚੀ ਬਣਾਓ
- ਕਿਹੜੀਆਂ ਭਾਸ਼ਾਵਾਂ ਅਤੇ ਰੂਪ (ਜਿਵੇਂ ਕਿ, ਅਮਰੀਕੀ ਅੰਗਰੇਜ਼ੀ ਬਨਾਮ ਭਾਰਤੀ ਅੰਗਰੇਜ਼ੀ ਬਨਾਮ ਸਿੰਗਾਪੁਰ ਅੰਗਰੇਜ਼ੀ)?
- ਕੀ ਤੁਹਾਨੂੰ ਲੋੜ ਹੈ ਕੋਡ-ਮਿਕਸਡ ਭਾਸ਼ਣ (ਹਿੰਦੀ-ਅੰਗਰੇਜ਼ੀ, ਸਪੈਨਿਸ਼-ਅੰਗਰੇਜ਼ੀ, ਆਦਿ)?
- ਕੀ ਤੁਸੀਂ ਘੱਟ-ਸਰੋਤ ਵਾਲੀਆਂ ਭਾਸ਼ਾਵਾਂ ਨੂੰ ਨਿਸ਼ਾਨਾ ਬਣਾ ਰਹੇ ਹੋ ਜਿੱਥੇ ਖੁੱਲ੍ਹਾ ਡੇਟਾ ਬਹੁਤ ਘੱਟ ਹੁੰਦਾ ਹੈ?
ਕਦਮ 3 - ਧੁਨੀ ਸਥਿਤੀਆਂ ਦਾ ਮੇਲ ਕਰੋ
- ਟੈਲੀਫੋਨੀ ਬਨਾਮ ਵਾਈਡਬੈਂਡ ਬਨਾਮ ਮਲਟੀ-ਮਾਈਕ ਐਰੇ।
- ਸ਼ਾਂਤ ਦਫਤਰ ਬਨਾਮ ਸ਼ੋਰ ਵਾਲੀ ਗਲੀ ਬਨਾਮ ਚਲਦੀ ਕਾਰ।
- ਨੇੜੇ-ਖੇਤਰ ਬਨਾਮ ਦੂਰ-ਖੇਤਰ ਮਾਈਕ੍ਰੋਫ਼ੋਨ।
ਤੁਹਾਡੇ ਡੇਟਾਸੈਟ ਨੂੰ ਉਹਨਾਂ ਵਾਤਾਵਰਣਾਂ ਨੂੰ ਦਰਸਾਉਣਾ ਚਾਹੀਦਾ ਹੈ ਜਿਨ੍ਹਾਂ ਵਿੱਚ ਤੁਹਾਡੇ ਉਪਭੋਗਤਾ ਅਸਲ ਵਿੱਚ ਹੋਣਗੇ ।
ਕਦਮ 4 – ਡੇਟਾਸੈੱਟ ਦੇ ਆਕਾਰ ਅਤੇ ਰਚਨਾ ਬਾਰੇ ਫੈਸਲਾ ਕਰੋ
ਜ਼ਰੂਰੀ ਨਿਯਮ (ਸਖਤ ਨਹੀਂ):
- ਪਹਿਲਾਂ ਤੋਂ ਸਿਖਲਾਈ ਪ੍ਰਾਪਤ ਮਾਡਲ ਨੂੰ ਸੁਧਾਰਨਾ (ਫ਼ੁਸਫ਼ੁਸ, wav2vec2, ਆਦਿ)
- ਦਰਜਨਾਂ ਤੋਂ ਕੁਝ ਸੌ ਘੰਟਿਆਂ ਦਾ ਉੱਚ-ਗੁਣਵੱਤਾ ਵਾਲਾ, ਡੋਮੇਨ-ਮੇਲ ਖਾਂਦਾ ਡੇਟਾ ਸੂਈ ਨੂੰ ਬਹੁਤ ਜ਼ਿਆਦਾ ਹਿਲਾ ਸਕਦਾ ਹੈ।
- ਸ਼ੁਰੂ ਤੋਂ ਇੱਕ ਮਾਡਲ ਨੂੰ ਸਿਖਲਾਈ ਦੇਣਾ
- ਆਮ ਤੌਰ 'ਤੇ ਹਜ਼ਾਰਾਂ ਤੋਂ ਲੈ ਕੇ ਹਜ਼ਾਰਾਂ ਘੰਟਿਆਂ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ, ਇਸੇ ਕਰਕੇ ਬਹੁਤ ਸਾਰੀਆਂ ਟੀਮਾਂ ਪਹਿਲਾਂ ਤੋਂ ਸਿਖਲਾਈ ਪ੍ਰਾਪਤ ਪ੍ਰਣਾਲੀਆਂ ਤੋਂ ਸ਼ੁਰੂਆਤ ਕਰਦੀਆਂ ਹਨ ਅਤੇ ਡੇਟਾ ਨੂੰ ਵਧੀਆ ਬਣਾਉਣ 'ਤੇ ਬਜਟ ਕੇਂਦਰਿਤ ਕਰਦੀਆਂ ਹਨ।
ਮਿਕਸ:
- ਕੁਝ ਸਾਫ਼ ਸਕ੍ਰਿਪਟਡ ਡੇਟਾ (ਮੂਲ ਧੁਨੀ ਵਿਗਿਆਨ, ਸੰਖਿਆਵਾਂ ਲਈ)।
- ਯਥਾਰਥਵਾਦੀ ਗੱਲਬਾਤ ਡਾਟਾ (ਮਜ਼ਬੂਤੀ ਲਈ)।
- ਡੋਮੇਨ-ਵਿਸ਼ੇਸ਼ ਕਿਨਾਰੇ ਦੇ ਮਾਮਲੇ (ਦੁਰਲੱਭ ਇਕਾਈਆਂ, ਲੰਬੇ ਨੰਬਰ, ਸ਼ਬਦਾਵਲੀ)।
ਕਦਮ 5 – ਲੇਬਲ ਅਤੇ ਮੈਟਾਡੇਟਾ ਦੀ ਜਾਂਚ ਕਰੋ
ਕਲਾਸਿਕ ASR ਲਈ, ਤੁਹਾਨੂੰ ਘੱਟੋ-ਘੱਟ ਇਹ ਚਾਹੀਦਾ ਹੈ:
- ਸਹੀ ਟ੍ਰਾਂਸਕ੍ਰਿਪਟਾਂ
- ਮੁੱਢਲੇ ਸਪੀਕਰ ਟੈਗ
- ਇਕਸਾਰ ਵਿਰਾਮ ਚਿੰਨ੍ਹ ਅਤੇ ਕੇਸਿੰਗ ਨਿਯਮ
LLM + ASR ਪਾਈਪਲਾਈਨਾਂ ਲਈ, ਤੁਸੀਂ ਇਹ ਵੀ ਚਾਹੁੰਦੇ ਹੋ:
- ਸਪੀਕਰ ਮੋੜ ਸੈਗਮੈਂਟੇਸ਼ਨ (ਕਿਸਨੇ ਕੀ ਕਿਹਾ, ਕਦੋਂ)
- ਕਾਲ/ਗੱਲਬਾਤ ਨਤੀਜੇ (ਹੱਲ ਕੀਤਾ ਗਿਆ, ਵਧਾਇਆ ਗਿਆ, ਸ਼ਿਕਾਇਤ ਦੀ ਕਿਸਮ)
- ਇਕਾਈ ਐਨੋਟੇਸ਼ਨ (ਨਾਮ, ਖਾਤਾ ਨੰਬਰ, ਉਤਪਾਦ ਦੇ ਨਾਮ)
- ਜਿੱਥੇ ਢੁਕਵਾਂ ਹੋਵੇ, ਭਾਵਨਾ ਜਾਂ ਭਾਵਨਾਵਾਂ ਦੇ ਟੈਗ।
ਇਹ ਲੇਬਲ ਤੁਹਾਨੂੰ ਟ੍ਰਾਂਸਕ੍ਰਿਪਟਾਂ ਦੇ ਸਿਖਰ 'ਤੇ ਸੰਖੇਪ, QA, ਕੋਚਿੰਗ, ਰੂਟਿੰਗ, ਅਤੇ RAG ਪਾਈਪਲਾਈਨਾਂ ਬਣਾਉਣ ਦਿੰਦੇ ਹਨ —ਜਿੱਥੇ ਹੁਣ ਬਹੁਤ ਸਾਰਾ ਵਪਾਰਕ ਮੁੱਲ ਰਹਿੰਦਾ ਹੈ।
ਕਦਮ 6 – ਲਾਇਸੈਂਸਿੰਗ, ਸਹਿਮਤੀ ਅਤੇ ਪਾਲਣਾ ਦੀ ਪੁਸ਼ਟੀ ਕਰੋ
ਸਿਖਲਾਈ ਤੋਂ ਪਹਿਲਾਂ:
- ਕੀ ਡੇਟਾਸੈੱਟ ਇਹਨਾਂ ਲਈ ਲਾਇਸੰਸਸ਼ੁਦਾ ਹੈ ਵਪਾਰਕ ਵਰਤੋਂ (ਸਿਰਫ਼ ਖੋਜ ਹੀ ਨਹੀਂ)?
- ਕੀ ਬੁਲਾਰਿਆਂ ਨੂੰ ਇਸ ਵਰਤੋਂ ਲਈ ਸੂਚਿਤ ਕੀਤਾ ਗਿਆ ਸੀ ਅਤੇ ਸਹਿਮਤੀ ਦਿੱਤੀ ਗਈ ਸੀ?
- ਕੀ PII ਅਤੇ ਸੰਵੇਦਨਸ਼ੀਲ ਵਿਸ਼ੇਸ਼ਤਾਵਾਂ ਨੂੰ GDPR / HIPAA / ਸਥਾਨਕ ਨਿਯਮਾਂ ਅਨੁਸਾਰ ਸੰਭਾਲਿਆ ਜਾਂਦਾ ਹੈ?
ਬਹੁਤ ਸਾਰੇ ਖੁੱਲ੍ਹੇ ਡੇਟਾਸੈੱਟ CC-BY ਜਾਂ CC0 ਵਰਗੇ ਲਾਇਸੈਂਸਾਂ ਦੀ ਵਰਤੋਂ ਕਰਦੇ ਹਨ , ਹਰੇਕ ਦੇ ਵੱਖ-ਵੱਖ ਫਰਜ਼ ਹੁੰਦੇ ਹਨ। ਜਦੋਂ ਸ਼ੱਕ ਹੋਵੇ, ਤਾਂ ਕਾਨੂੰਨੀ ਸਮੀਖਿਆ ਨੂੰ ਇੱਕ ਗੈਰ-ਗੱਲਬਾਤਯੋਗ ਕਦਮ ਵਜੋਂ ਮੰਨੋ।
ਕਦਮ 7 – ਨਿਰੰਤਰ ਡੇਟਾਸੈੱਟ ਸੁਧਾਰ ਦੀ ਯੋਜਨਾ ਬਣਾਓ
ਭਾਸ਼ਾਵਾਂ ਵਿਕਸਤ ਹੁੰਦੀਆਂ ਹਨ, ਤੁਹਾਡਾ ਉਤਪਾਦ ਵਿਕਸਤ ਹੁੰਦਾ ਹੈ, ਅਤੇ ਇਸੇ ਤਰ੍ਹਾਂ ਤੁਹਾਡਾ ਡੇਟਾਸੈਟ ਵੀ ਵਿਕਸਤ ਹੋਣਾ ਚਾਹੀਦਾ ਹੈ:
- ਅਸਲ-ਸੰਸਾਰ ਦੀਆਂ ਗਲਤੀਆਂ ਦੀ ਨਿਗਰਾਨੀ ਕਰੋ ਅਤੇ ਗਲਤ ਪਛਾਣਾਂ ਨੂੰ ਆਪਣੇ ਸਿਖਲਾਈ ਸੈੱਟ ਵਿੱਚ ਵਾਪਸ ਪਾਓ।
- ਜਿਵੇਂ-ਜਿਵੇਂ ਤੁਹਾਡਾ ਡੋਮੇਨ ਬਦਲਦਾ ਹੈ, ਨਵੀਆਂ ਇਕਾਈਆਂ (ਬ੍ਰਾਂਡ, SKU, ਰੈਗੂਲੇਟਰੀ ਸ਼ਰਤਾਂ) ਸ਼ਾਮਲ ਕਰੋ।
- ਪੱਖਪਾਤ ਨੂੰ ਘਟਾਉਣ ਲਈ ਸਮੇਂ-ਸਮੇਂ 'ਤੇ ਲਹਿਜ਼ੇ ਅਤੇ ਜਨਸੰਖਿਆ ਨੂੰ ਮੁੜ ਸੰਤੁਲਿਤ ਕਰੋ।
ਇਹ ਬੰਦ ਚੱਕਰ ਅਕਸਰ "ਕਾਫ਼ੀ ਵਧੀਆ" ਅਤੇ "ਮਾਰਕੀਟ-ਮੋਹਰੀ" ਭਾਸ਼ਣ ਉਤਪਾਦਾਂ ਵਿਚਕਾਰ ਸਭ ਤੋਂ ਵੱਡਾ ਅੰਤਰ ਹੁੰਦਾ ਹੈ।
[ਇਹ ਵੀ ਪੜ੍ਹੋ: ਸਾਡੇ ਗੁਣਵੱਤਾ ਵਾਲੇ ਭਾਰਤੀ ਭਾਸ਼ਾ ਦੇ ਆਡੀਓ ਡੇਟਾਸੈਟਾਂ ਨਾਲ AI ਮਾਡਲਾਂ ਨੂੰ ਵਧਾਓ ।]
ਸ਼ੈਪ ਕਿਵੇਂ ਮਦਦ ਕਰ ਸਕਦਾ ਹੈ
ਜੇਕਰ ਤੁਸੀਂ "ਮੈਨੂੰ ਪਤਾ ਹੈ ਕਿ ਮੈਨੂੰ ਬਿਹਤਰ ਸਪੀਚ ਡੇਟਾ ਦੀ ਲੋੜ ਹੈ, ਪਰ ਮੈਨੂੰ ਯਕੀਨ ਨਹੀਂ ਹੈ ਕਿ ਕਿੱਥੋਂ ਸ਼ੁਰੂ ਕਰਨਾ ਹੈ" ਦੇ ਪੜਾਅ 'ਤੇ ਹੋ , ਤਾਂ ਸ਼ੈਪ ਤੁਹਾਡੀ ਮਦਦ ਕਰ ਸਕਦਾ ਹੈ:
- ਆਪਣੇ ਮੌਜੂਦਾ ਡੇਟਾਸੈਟਾਂ ਦਾ ਆਡਿਟ ਕਰੋ ਅਤੇ ਪਛਾਣ ਕਰੋ ਕਵਰੇਜ ਗੈਪ
- ਪ੍ਰਦਾਨ ਕਰੋ ਆਮ ਬੋਲੀ ਪਛਾਣ ਡੇਟਾਸੈੱਟ 65+ ਭਾਸ਼ਾਵਾਂ ਅਤੇ ਦਰਜਨਾਂ ਡੋਮੇਨਾਂ (ਸਕ੍ਰਿਪਟਡ, ਕਾਲ ਸੈਂਟਰ, ਵੇਕ ਵਰਡਜ਼, ਟੀਟੀਐਸ, ਆਦਿ) ਵਿੱਚ
- ਡਿਜ਼ਾਈਨ ਅਤੇ ਲਾਗੂ ਕਰੋ ਕਸਟਮ ਡਾਟਾ ਇਕੱਠਾ ਪ੍ਰੋਗਰਾਮ (ਰਿਮੋਟ, ਦੇਸ਼ ਦੇ ਅੰਦਰ, ਮਲਟੀ-ਡਿਵਾਈਸ)
- ਵਰਤ ਐਨੋਟੇਸ਼ਨ, ਟ੍ਰਾਂਸਕ੍ਰਿਪਸ਼ਨ, ਗੁਣਵੱਤਾ ਨਿਯੰਤਰਣ, ਅਤੇ ਪਛਾਣ ਦੀ ਅਣ-ਪਛਾਣ ਅੰਤ ਤੋਂ ਅੰਤ
ਇਸ ਲਈ ਤੁਹਾਡੀ ਟੀਮ ਮਾਡਲਾਂ ਅਤੇ ਉਤਪਾਦਾਂ ' ਤੇ ਧਿਆਨ ਕੇਂਦਰਿਤ ਕਰ ਸਕਦੀ ਹੈ , ਜਦੋਂ ਕਿ ਅਸੀਂ ਇਹ ਯਕੀਨੀ ਬਣਾਉਂਦੇ ਹਾਂ ਕਿ ਤੁਹਾਡੇ AI ਕੋਲ ਉੱਚ-ਗੁਣਵੱਤਾ ਵਾਲਾ, ਅਨੁਕੂਲ ਭਾਸ਼ਣ ਡੇਟਾ ਹੈ ਜਿਸਦੀ ਇਸਨੂੰ ਸੁਣਨ-ਅਤੇ ਸਮਝਣ ਲਈ ਲੋੜ ਹੈ।