

ਰੀਇਨਫੋਰਸਮੈਂਟ ਲਰਨਿੰਗ (RL) ਇਹ ਸਿੱਖਣ ਵਿੱਚ ਬਹੁਤ ਵਧੀਆ ਹੈ ਕਿ ਜਦੋਂ ਇਨਾਮ ਸਿਗਨਲ ਸਾਫ਼ ਹੋਵੇ ਅਤੇ ਵਾਤਾਵਰਣ ਮਾਫ਼ ਕਰਨ ਵਾਲਾ ਹੋਵੇ ਤਾਂ ਕੀ ਕਰਨਾ ਹੈ। ਪਰ ਬਹੁਤ ਸਾਰੀਆਂ ਅਸਲ-ਸੰਸਾਰ ਸੈਟਿੰਗਾਂ ਇਸ ਤਰ੍ਹਾਂ ਦੀਆਂ ਨਹੀਂ ਹਨ। ਉਹ ਗੜਬੜ ਵਾਲੀਆਂ, ਉੱਚ-ਦਾਅ ਵਾਲੀਆਂ, ਅਤੇ "ਲਗਭਗ ਸਹੀ" ਫੈਸਲਿਆਂ ਨਾਲ ਭਰੀਆਂ ਹੁੰਦੀਆਂ ਹਨ। ਇਹੀ ਉਹ ਥਾਂ ਹੈ ਜਿੱਥੇ ਮਾਹਰ-ਜਾਂਚ ਕੀਤੇ ਤਰਕ ਡੇਟਾਸੈੱਟ ਇੱਕ ਬਲ ਗੁਣਕ ਬਣ ਜਾਂਦੇ ਹਨ: ਉਹ ਮਾਡਲਾਂ ਨੂੰ ਕਿਸੇ ਕਾਰਵਾਈ ਦੇ ਪਿੱਛੇ ਦਾ ਕਾਰਨ ਸਿਖਾਉਂਦੇ ਹਨ - ਨਾ ਕਿ ਸਿਰਫ਼ ਨਤੀਜਾ।
RL ਪ੍ਰਦਰਸ਼ਨ ਵਿੱਚ ਲੁਕੀ ਹੋਈ ਰੁਕਾਵਟ: ਕਮਜ਼ੋਰ ਤਰਕ ਸੰਕੇਤ
RL ਏਜੰਟ ਸਿਖਲਾਈ ਵਿੱਚ ਪ੍ਰਭਾਵਸ਼ਾਲੀ ਦਿਖਾਈ ਦੇ ਸਕਦੇ ਹਨ ਅਤੇ ਫਿਰ ਵੀ ਤੈਨਾਤੀ ਵਿੱਚ ਅਸਫਲ ਹੋ ਸਕਦੇ ਹਨ। ਇੱਕ ਆਮ ਕਾਰਨ ਇਹ ਹੈ ਕਿ ਮਾਡਲ ਸ਼ਾਰਟਕੱਟ ਸਿੱਖਦਾ ਹੈ - ਪੈਟਰਨ ਜੋ ਜਾਣੇ-ਪਛਾਣੇ ਦ੍ਰਿਸ਼ਾਂ ਵਿੱਚ ਇਨਾਮ ਕਮਾਉਂਦੇ ਹਨ ਪਰ ਹਾਲਾਤ ਬਦਲਣ 'ਤੇ ਢਹਿ ਜਾਂਦੇ ਹਨ।
ਇੱਥੇ ਇੱਕ ਛੋਟੀ-ਕਹਾਣੀ ਹੈ ਜਿਸਨੂੰ ਤੁਸੀਂ ਪਛਾਣ ਸਕੋਗੇ ਜੇਕਰ ਤੁਸੀਂ RL ਸਿਸਟਮ ਭੇਜੇ ਹਨ:
ਇੱਕ ਵੇਅਰਹਾਊਸ ਰੋਬੋਟਿਕਸ ਟੀਮ ਇੱਕ ਏਜੰਟ ਨੂੰ ਚੀਜ਼ਾਂ ਚੁਣਨ ਅਤੇ ਰੱਖਣ ਲਈ ਸਿਖਲਾਈ ਦਿੰਦੀ ਹੈ। ਸਿਮੂਲੇਸ਼ਨ ਵਿੱਚ, ਸਫਲਤਾ ਦੀਆਂ ਦਰਾਂ ਤੇਜ਼ੀ ਨਾਲ ਵੱਧਦੀਆਂ ਹਨ। ਪਰ ਅਸਲ ਮੰਜ਼ਿਲਾਂ 'ਤੇ, ਰੋਬੋਟ ਸੈੱਟਅੱਪ ਨੂੰ "ਗੇਮ" ਕਰਨਾ ਸ਼ੁਰੂ ਕਰ ਦਿੰਦਾ ਹੈ - ਜੋਖਮ ਭਰੇ ਟ੍ਰੈਜੈਕਟਰੀਆਂ ਨੂੰ ਲੈ ਕੇ ਜੋ ਸਿਮੂਲੇਟਰ ਵਿੱਚ ਕੰਮ ਕਰਦੇ ਹਨ ਪਰ ਪ੍ਰਤੀਬਿੰਬਤ ਸਤਹਾਂ ਦੇ ਨੇੜੇ ਟੱਕਰਾਂ ਦਾ ਕਾਰਨ ਬਣਦੇ ਹਨ। ਇਨਾਮ ਫੰਕਸ਼ਨ ਗਲਤ ਨਹੀਂ ਸੀ। ਮਾਡਲ ਦੁਆਰਾ ਸਿੱਖਿਆ ਗਿਆ ਤਰਕ ਅਧੂਰਾ ਸੀ।
ਜਦੋਂ ਤੁਹਾਡਾ ਡੇਟਾ ਸਿਰਫ਼ ਨਤੀਜਿਆਂ ("ਸਫਲਤਾ/ਅਸਫਲਤਾ" ਜਾਂ ਇੱਕ ਸਕੇਲਰ ਇਨਾਮ) ਨੂੰ ਕੈਪਚਰ ਕਰਦਾ ਹੈ, ਤਾਂ ਤੁਸੀਂ ਵਿਚਕਾਰਲੇ ਫੈਸਲੇ ਦੇ ਤਰਕ ਨੂੰ ਗੁਆ ਦਿੰਦੇ ਹੋ ਜੋ ਮਨੁੱਖ ਸਹਿਜ ਰੂਪ ਵਿੱਚ ਵਰਤਦੇ ਹਨ: ਪਾਬੰਦੀਆਂ, ਸੁਰੱਖਿਆ ਜਾਂਚਾਂ, ਅਤੇ ਕਦਮ ਕ੍ਰਮ।
"ਮਾਹਰ-ਜਾਂਚ ਕੀਤੇ ਤਰਕ ਡੇਟਾ" ਵਿੱਚ ਅਸਲ ਵਿੱਚ ਕੀ ਸ਼ਾਮਲ ਹੈ
ਵਿਹਾਰਕ ਪੱਧਰ 'ਤੇ, ਮਾਹਰ-ਜਾਂਚਿਆ ਤਰਕ ਡੇਟਾ ਉਦਾਹਰਣਾਂ ਦਾ ਇੱਕ ਕਿਉਰੇਟਿਡ ਸੈੱਟ ਹੈ ਜਿੱਥੇ ਡੋਮੇਨ ਮਾਹਰ ਫੈਸਲੇ ਦੇ ਮਾਰਗ ਨੂੰ ਪ੍ਰਮਾਣਿਤ ਕਰਦੇ ਹਨ - ਨਾ ਕਿ ਸਿਰਫ਼ ਅੰਤਿਮ ਨਤੀਜਾ।
ਤਰਕ ਦੇ ਨਿਸ਼ਾਨ: ਗੁੰਮ ਹੋਇਆ ਵਿਚਕਾਰਲਾ ਹਿੱਸਾ
ਇੱਕ ਤਰਕ ਟਰੇਸ ਨਿਰੀਖਣ → ਫੈਸਲਾ → ਕਾਰਵਾਈ ਤੋਂ ਕਦਮ-ਦਰ-ਕਦਮ ਰਸਤਾ ਹੈ। ਤੁਹਾਡੇ ਵਰਤੋਂ ਦੇ ਮਾਮਲੇ 'ਤੇ ਨਿਰਭਰ ਕਰਦੇ ਹੋਏ, ਇਹ ਇਸ ਤਰ੍ਹਾਂ ਦਿਖਾਈ ਦੇ ਸਕਦਾ ਹੈ:
- ਸੰਬੰਧਿਤ ਸਿਗਨਲਾਂ ਦੀ ਪਛਾਣ ਕਰਨਾ ("ਸੈਂਸਰ ਡ੍ਰਿਫਟ ਦਾ ਪਤਾ ਲੱਗਿਆ; ਵਿਸ਼ਵਾਸ ਘੱਟ ਗਿਆ")
- ਡੋਮੇਨ ਨਿਯਮਾਂ ਨੂੰ ਲਾਗੂ ਕਰਨਾ ("ਦਾਖਲ ਹੋਣ ਤੋਂ ਪਹਿਲਾਂ ਉਪਜ ਦਿਓ; ਪੈਦਲ ਚੱਲਣ ਵਾਲਿਆਂ ਨੂੰ ਤਰਜੀਹ ਦਿਓ")
- ਪਾਬੰਦੀਆਂ ਵਾਲੀਆਂ ਕਾਰਵਾਈਆਂ ਦੀ ਚੋਣ ਕਰਨਾ ("ਬਲਾਈਂਡ ਸਪਾਟ ਤੋਂ ਬਚਣ ਲਈ ਮਾਰਗ B ਚੁਣੋ")
"ਨਿਰੀਖਣ ਕੀਤਾ" ਦਾ ਕੀ ਅਰਥ ਹੈ (ਸਾਦੀ ਅੰਗਰੇਜ਼ੀ ਵਿੱਚ)
"ਜਾਂਚਿਆ ਗਿਆ" ਵਿੱਚ ਆਮ ਤੌਰ 'ਤੇ ਸ਼ਾਮਲ ਹੁੰਦੇ ਹਨ:
- ਮਾਹਰ-ਲਿਖਤ ਜਾਂ ਮਾਹਰ-ਸਮੀਖਿਆ ਕੀਤੇ ਦਿਸ਼ਾ-ਨਿਰਦੇਸ਼
- ਇਕਸਾਰ ਲੇਬਲਿੰਗ ਰੁਬਰਿਕਸ (ਤਾਂ ਜੋ ਦੋ ਮਾਹਰ ਇੱਕੋ ਮਾਮਲੇ ਨੂੰ ਇੱਕੋ ਤਰੀਕੇ ਨਾਲ ਹੱਲ ਕਰਨ)
- ਵਿਰੋਧਾਭਾਸਾਂ ਅਤੇ ਗੁੰਮ ਹੋਏ ਕਦਮਾਂ ਲਈ ਯੋਜਨਾਬੱਧ ਜਾਂਚਾਂ
- ਦਿਸ਼ਾ-ਨਿਰਦੇਸ਼ਾਂ ਦੇ ਵਿਕਾਸ ਦੇ ਨਾਲ-ਨਾਲ ਤਬਦੀਲੀਆਂ ਦਾ ਇੱਕ ਆਡਿਟ ਟ੍ਰੇਲ
ਇਹ ਮਾਇਨੇ ਰੱਖਦਾ ਹੈ ਕਿਉਂਕਿ ਛੋਟੀਆਂ ਤਰਕ ਗਲਤੀਆਂ ਕੈਸਕੇਡ ਹੋ ਸਕਦੀਆਂ ਹਨ - ਖਾਸ ਕਰਕੇ ਜਦੋਂ ਤੁਸੀਂ ਬਾਅਦ ਵਿੱਚ ਇਨਾਮ ਮਾਡਲਾਂ ਨੂੰ ਸਿਖਲਾਈ ਦਿੰਦੇ ਹੋ ਜਾਂ ਮਨੁੱਖੀ ਫੀਡਬੈਕ ਲੂਪਾਂ ਦੀ ਵਰਤੋਂ ਕਰਦੇ ਹੋ।
ਤਰਕ ਡੇਟਾਸੈੱਟ ਰੀਨਫੋਰਸਮੈਂਟ ਲਰਨਿੰਗ ਮਾਡਲ ਪ੍ਰਦਰਸ਼ਨ ਨੂੰ ਕਿਵੇਂ ਬਿਹਤਰ ਬਣਾਉਂਦੇ ਹਨ
ਫਾਇਦੇ ਰਹੱਸਮਈ ਨਹੀਂ ਹਨ। ਉਹ ਮਕੈਨੀਕਲ ਹਨ।
ਤੇਜ਼ ਕਨਵਰਜੈਂਸ, ਘੱਟ ਇਨਾਮ ਹੈਕਿੰਗ
ਤਰਕਸ਼ੀਲ ਨਿਸ਼ਾਨ ਖੋਜ ਦੀ ਜਗ੍ਹਾ ਨੂੰ ਘਟਾਉਂਦੇ ਹਨ। ਅੰਨ੍ਹੇਵਾਹ ਖੋਜ ਕਰਨ ਦੀ ਬਜਾਏ, ਏਜੰਟ ਨੂੰ ਢਾਂਚਾਗਤ ਸੰਕੇਤ ਮਿਲਦੇ ਹਨ ਕਿ ਕਿਹੜੇ ਵਿਚਕਾਰਲੇ ਕਦਮ ਵੈਧ ਹਨ। ਇਸਦਾ ਆਮ ਤੌਰ 'ਤੇ ਮਤਲਬ ਹੈ ਕਿ ਘੱਟ ਸਿਖਲਾਈ ਦੁਹਰਾਓ ਡੈੱਡ ਐਂਡ 'ਤੇ ਬਰਬਾਦ ਹੁੰਦੇ ਹਨ ਅਤੇ ਇਨਾਮ ਫੰਕਸ਼ਨ ਦੇ ਘੱਟ "ਚਲਾਕ" ਕਾਰਨਾਮੇ ਹੁੰਦੇ ਹਨ।
RLHF ਅਤੇ ਇਨਾਮ ਮਾਡਲਿੰਗ 'ਤੇ ਖੋਜ ਵਾਰ-ਵਾਰ ਇਸ ਗੱਲ ਨੂੰ ਉਜਾਗਰ ਕਰਦੀ ਹੈ ਕਿ ਸਿਖਲਾਈ ਸ਼ੋਰ-ਸ਼ਰਾਬੇ ਵਾਲੇ ਜਾਂ ਘੱਟ-ਗੁਣਵੱਤਾ ਵਾਲੇ ਤਰਜੀਹ/ਫੀਡਬੈਕ ਡੇਟਾ ਲਈ ਕਿੰਨੀ ਸੰਵੇਦਨਸ਼ੀਲ ਹੋ ਸਕਦੀ ਹੈ (ਸਰੋਤ: ਐਸੋਸੀਏਸ਼ਨ ਫਾਰ ਕੰਪਿਊਟੇਸ਼ਨਲ ਲਿੰਗੁਇਸਟਿਕਸ, 2024)। ਇਹ ਸੰਵੇਦਨਸ਼ੀਲਤਾ RL ਵਿੱਚ ਅਲੋਪ ਨਹੀਂ ਹੁੰਦੀ - ਇਹ ਵਧਦੀ ਹੈ।
ਕਿਨਾਰੇ ਵਾਲੇ ਮਾਮਲਿਆਂ ਲਈ ਬਿਹਤਰ ਸਧਾਰਣਕਰਨ
ਮਾਹਰ ਤਰਕ ਉਹਨਾਂ ਪਾਬੰਦੀਆਂ ਅਤੇ ਸਿਧਾਂਤਾਂ ਨੂੰ ਏਨਕੋਡ ਕਰਦਾ ਹੈ ਜੋ ਟ੍ਰਾਂਸਫਰ ਕਰਦੇ ਹਨ: ਸੁਰੱਖਿਆ ਸੀਮਾਵਾਂ, ਪਾਲਣਾ ਨਿਯਮ, ਅਤੇ ਕਾਰਣ ਤਰਕ। ਜਦੋਂ ਵਾਤਾਵਰਣ ਬਦਲਦਾ ਹੈ, ਤਾਂ ਉਹ ਸਿਧਾਂਤ ਅਜੇ ਵੀ ਕਾਇਮ ਰਹਿੰਦੇ ਹਨ - ਭਾਵੇਂ ਸਹੀ ਪਿਕਸਲ, ਟੈਕਸਟ, ਜਾਂ ਸਥਿਤੀ ਪਰਿਵਰਤਨ ਨਾ ਵੀ ਹੋਣ।
ਵਧੇਰੇ ਸਥਿਰ ਇਨਾਮ ਮਾਡਲਿੰਗ ਅਤੇ RLHF ਲੂਪਸ
ਜੇਕਰ ਤੁਸੀਂ RLHF-ਸ਼ੈਲੀ ਤੋਂ ਬਾਅਦ ਦੀ ਸਿਖਲਾਈ ਦੀ ਵਰਤੋਂ ਕਰ ਰਹੇ ਹੋ, ਤਾਂ ਤਰਕ ਡੇਟਾ ਤੁਹਾਨੂੰ ਬਿਹਤਰ ਇਨਾਮ ਮਾਡਲ ਬਣਾਉਣ ਵਿੱਚ ਮਦਦ ਕਰਦਾ ਹੈ - ਕਿਉਂਕਿ ਇਨਾਮ ਮਾਡਲ ਨਾ ਸਿਰਫ਼ "ਚੰਗੇ ਜਵਾਬ", ਸਗੋਂ "ਚੰਗੇ ਫੈਸਲੇ ਲੈਣ ਵਾਲੇ ਮਾਰਗ" ਸਕੋਰ ਕਰਨਾ ਸਿੱਖ ਸਕਦਾ ਹੈ। ਇਹ ਅਨੁਕੂਲਤਾ ਦੌਰਾਨ ਵਧੇਰੇ ਇਕਸਾਰ ਅੱਪਡੇਟ ਅਤੇ ਸਿਖਲਾਈ ਨੂੰ ਸਕੇਲ ਕਰਨ ਵੇਲੇ ਘੱਟ ਰਿਗਰੈਸ਼ਨ ਵਿੱਚ ਅਨੁਵਾਦ ਕਰਦਾ ਹੈ।
ਜੇਕਰ ਤੁਸੀਂ RLHF ਪਾਈਪਲਾਈਨਾਂ ਬਣਾ ਰਹੇ ਹੋ ਜਾਂ ਸਕੇਲ ਕਰ ਰਹੇ ਹੋ, ਤਾਂ Shaip ਦੇ RLHF ਹੱਲ ਮਾਹਰ-ਅਗਵਾਈ ਵਾਲੇ ਵਰਕਫਲੋ ਅਤੇ ਗੁਣਵੱਤਾ ਨਿਯੰਤਰਣਾਂ ਦੇ ਆਲੇ-ਦੁਆਲੇ ਤਿਆਰ ਕੀਤੇ ਗਏ ਹਨ ਜੋ ਇਕਸਾਰ ਅਲਾਈਨਮੈਂਟ ਡੇਟਾ ਦਾ ਸਮਰਥਨ ਕਰਦੇ ਹਨ।
ਇੱਕ ਸਮਾਨਤਾ: ਉਡਾਣ ਦੇ ਘੰਟੇ ਬਨਾਮ ਉਡਾਣ ਨਿਰਦੇਸ਼
RL ਸਿਖਲਾਈ ਨੂੰ ਪਾਇਲਟ ਸਿਖਲਾਈ ਵਾਂਗ ਸੋਚੋ। ਤੁਸੀਂ ਇਕੱਲੇ ਸਿਮੂਲੇਟਰ ਵਿੱਚ ਬੇਅੰਤ ਘੰਟੇ ਬਿਤਾ ਸਕਦੇ ਹੋ - ਪਰ ਜੇ ਤੁਸੀਂ ਗਲਤ ਆਦਤਾਂ ਦਾ ਅਭਿਆਸ ਕਰਦੇ ਹੋ, ਤਾਂ ਤੁਸੀਂ ਉਨ੍ਹਾਂ ਨੂੰ ਮਜ਼ਬੂਤ ਕਰੋਗੇ। ਇੱਕ ਇੰਸਟ੍ਰਕਟਰ ਸਿਰਫ਼ "ਪਾਸ/ਫੇਲ" ਨਹੀਂ ਕਹਿੰਦਾ। ਉਹ ਉਡਾਣ ਦੇ ਵਿਚਕਾਰ ਤੁਹਾਡੇ ਤਰਕ ਨੂੰ ਠੀਕ ਕਰਦੇ ਹਨ: ਸਕੈਨ ਆਰਡਰ, ਫੈਸਲੇ ਦਾ ਸਮਾਂ, ਅਤੇ ਜੋਖਮ ਸੰਭਾਲਣਾ। ਮਾਹਰ-ਜਾਂਚ ਕੀਤੇ ਤਰਕ ਡੇਟਾਸੈੱਟ RL ਲਈ ਉਹ "ਇੰਸਟ੍ਰਕਟਰ" ਭੂਮਿਕਾ ਨਿਭਾਉਂਦੇ ਹਨ - ਮਾਡਲ ਨੂੰ ਕੰਮ ਨੂੰ ਕਿਵੇਂ ਸੋਚਣਾ ਹੈ, ਇਹ ਸਿਖਾਉਣਾ ਕਿ ਇਹ ਸਿਰਫ਼ ਉਤਰਿਆ ਹੈ ਜਾਂ ਨਹੀਂ।
ਤੁਲਨਾ ਸਾਰਣੀ: ਇਨ-ਹਾਊਸ ਬਨਾਮ ਕਰਾਊਡਸੋਰਸਡ ਬਨਾਮ ਆਊਟਸੋਰਸਡ ਵੈਟਿੰਗ ਮਾਡਲ
ਜ਼ਿਆਦਾਤਰ ਟੀਮਾਂ ਇੱਕ ਹਾਈਬ੍ਰਿਡ ਨਾਲ ਖਤਮ ਹੁੰਦੀਆਂ ਹਨ, ਪਰ ਇਹ ਵਪਾਰ-ਆਫ ਬਾਰੇ ਸਪੱਸ਼ਟ ਹੋਣ ਵਿੱਚ ਮਦਦ ਕਰਦਾ ਹੈ।
RL ਅਤੇ RLHF ਪਾਈਪਲਾਈਨਾਂ ਨਾਲ ਜੁੜਨ ਵਾਲੀਆਂ ਵਿਆਪਕ ਲੇਬਲਿੰਗ ਜ਼ਰੂਰਤਾਂ ਲਈ, Shaip ਦੀਆਂ ਡੇਟਾ ਐਨੋਟੇਸ਼ਨ ਸੇਵਾਵਾਂ ਗਾਈਡਲਾਈਨ ਡਿਜ਼ਾਈਨ ਤੋਂ ਲੈ ਕੇ ਮਲਟੀ-ਸਟੇਜ QA ਤੱਕ ਹਰ ਚੀਜ਼ ਦਾ ਸਮਰਥਨ ਕਰ ਸਕਦੀਆਂ ਹਨ - ਖਾਸ ਕਰਕੇ ਜਦੋਂ ਤੁਹਾਨੂੰ ਪੈਮਾਨੇ 'ਤੇ ਦੁਹਰਾਉਣ ਯੋਗ ਗੁਣਵੱਤਾ ਦੀ ਲੋੜ ਹੁੰਦੀ ਹੈ।
ਮਾਹਰ-ਜਾਂਚ ਕੀਤੇ ਤਰਕ ਡੇਟਾਸੈਟਾਂ ਲਈ ਇੱਕ ਵਿਹਾਰਕ QC ਪਲੇਬੁੱਕ
ਇੱਥੇ ਇੱਕ ਪਲੇਬੁੱਕ ਹੈ ਜੋ ਉੱਚ-ਪ੍ਰਦਰਸ਼ਨ ਵਾਲੀਆਂ ਟੀਮਾਂ ਦੁਆਰਾ ਸੰਚਾਲਿਤ ਕੀਤੇ ਜਾਣ ਵਾਲੇ ਕੰਮਾਂ ਦਾ ਨਕਸ਼ਾ ਤਿਆਰ ਕਰਦੀ ਹੈ।
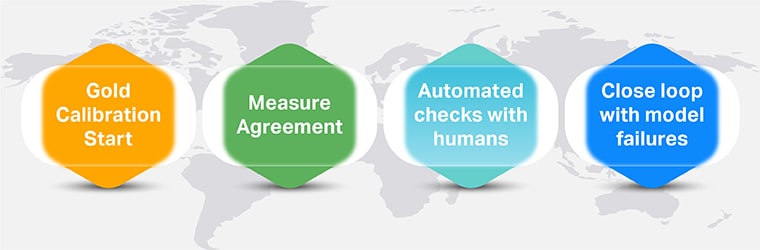
1. "ਸੋਨਾ" ਅਤੇ ਕੈਲੀਬ੍ਰੇਸ਼ਨ ਨਾਲ ਸ਼ੁਰੂ ਕਰੋ
ਕੈਨੋਨੀਕਲ ਉਦਾਹਰਣਾਂ ਦਾ ਇੱਕ ਸੁਨਹਿਰੀ ਸੈੱਟ ਬਣਾਓ (ਟ੍ਰਿਕਲ ਐਜ ਕੇਸਾਂ ਸਮੇਤ)। ਇਸਦੀ ਵਰਤੋਂ ਐਨੋਟੇਟਰਾਂ ਨੂੰ ਕੈਲੀਬਰੇਟ ਕਰਨ ਅਤੇ ਮਾਹਰਾਂ ਨੂੰ "ਚੰਗਾ ਤਰਕ" ਕਿਹੋ ਜਿਹਾ ਦਿਖਾਈ ਦਿੰਦਾ ਹੈ, ਇਸ ਬਾਰੇ ਇਕਸਾਰ ਕਰਨ ਲਈ ਕਰੋ।
2. ਸਹਿਮਤੀ ਨੂੰ ਮਾਪੋ—ਫਿਰ ਅਸਹਿਮਤੀ ਨੂੰ ਸਹੀ ਢੰਗ ਨਾਲ ਹੱਲ ਕਰੋ
ਜਿੱਥੇ ਸਮਝ ਆਉਂਦੀ ਹੋਵੇ ਉੱਥੇ ਇੰਟਰ-ਐਨੋਟੇਟਰ ਸਮਝੌਤੇ ਦੀ ਵਰਤੋਂ ਕਰੋ (ਅਤੇ ਅੰਦਰੂਨੀ ਤੌਰ 'ਤੇ ਅਸਪਸ਼ਟ ਮਾਮਲਿਆਂ 'ਤੇ ਸਮਝੌਤੇ ਲਈ ਮਜਬੂਰ ਕਰਨ ਤੋਂ ਬਚੋ)। ਕੁੰਜੀ ਸਾਲਸੀ ਹੈ : ਅਸਹਿਮਤੀ ਬਿਹਤਰ ਦਿਸ਼ਾ-ਨਿਰਦੇਸ਼ ਪੈਦਾ ਕਰਨੇ ਚਾਹੀਦੇ ਹਨ, ਨਾ ਕਿ ਸਿਰਫ਼ ਸਿੱਕਾ ਫਲਿੱਪ ਲੇਬਲ।
3. ਆਟੋਮੇਟਿਡ ਜਾਂਚਾਂ ਸ਼ਾਮਲ ਕਰੋ, ਪਰ ਮਨੁੱਖਾਂ ਨੂੰ ਇੰਚਾਰਜ ਰੱਖੋ
ਸਸਤੇ ਦੀ ਪੁਸ਼ਟੀ ਕਰਨ ਲਈ ਸਵੈਚਾਲਤ ਕਰੋ:
- ਫਾਰਮੈਟ ਇਕਸਾਰਤਾ (ਕਦਮਾਂ ਦੀ ਗਿਣਤੀ, ਸਕੀਮਾ ਵੈਧਤਾ)
- ਨਿਯਮਾਂ ਦੀ ਉਲੰਘਣਾ (ਲਾਪਤਾ ਪਾਬੰਦੀਆਂ, ਵਰਜਿਤ ਕਾਰਵਾਈਆਂ)
- ਵਿਰੋਧਾਭਾਸ ਖੋਜ (ਕਦਮ "A" ਕਹਿੰਦਾ ਹੈ, ਬਾਅਦ ਵਿੱਚ "A ਨਹੀਂ" ਦਰਸਾਉਂਦਾ ਹੈ)
ਫਿਰ ਫਲੈਗ ਕੀਤੀਆਂ ਚੀਜ਼ਾਂ ਨੂੰ ਮਾਹਰ ਸਮੀਖਿਆ ਵੱਲ ਭੇਜੋ। ਇਹ ਉਹ ਥਾਂ ਹੈ ਜਿੱਥੇ ਹਾਈਬ੍ਰਿਡ ਹਿਊਮਨ+ਏਆਈ ਕਿਊਸੀ ਦਾ ਫਾਇਦਾ ਹੁੰਦਾ ਹੈ: ਮਸ਼ੀਨਾਂ "ਸਪੱਸ਼ਟ ਗਲਤੀ" ਨੂੰ ਫੜਦੀਆਂ ਹਨ, ਮਾਹਰ "ਸੂਖਮ ਗਲਤੀ" ਨੂੰ ਠੀਕ ਕਰਦੇ ਹਨ।
4. ਮਾਡਲ ਅਸਫਲਤਾਵਾਂ ਦੇ ਨਾਲ ਲੂਪ ਬੰਦ ਕਰੋ
ਤੈਨਾਤੀ ਅਸਫਲਤਾਵਾਂ ਨੂੰ ਡੇਟਾਸੈਟ ਫੀਡਬੈਕ ਵਜੋਂ ਮੰਨੋ। ਜਦੋਂ ਮਾਡਲ ਅਸਫਲ ਹੋ ਜਾਂਦਾ ਹੈ, ਤਾਂ ਪੁੱਛੋ:
- ਕੀ ਤਰਕ ਟਰੇਸ ਵਿੱਚ ਕੋਈ ਰੁਕਾਵਟ ਗੁੰਮ ਸੀ?
- ਕੀ ਦਿਸ਼ਾ-ਨਿਰਦੇਸ਼ਾਂ ਨੇ ਕਿਨਾਰੇ ਦੇ ਮਾਮਲੇ ਨੂੰ ਘੱਟ ਦਰਸਾਇਆ ਸੀ?
- ਕੀ ਅਸੀਂ "ਖੁਸ਼ ਮਾਰਗ" ਦੇ ਤਰਕ ਦੇ ਅਨੁਕੂਲ ਹੋ ਗਏ ਹਾਂ?
ਉਹ ਲੂਪ ਤੁਹਾਡੇ ਡੇਟਾਸੈੱਟ ਨੂੰ ਇੱਕ ਜੀਵਤ ਸੰਪਤੀ ਵਿੱਚ ਬਦਲ ਦਿੰਦਾ ਹੈ, ਇੱਕ ਵਾਰ ਡਿਲੀਵਰ ਹੋਣ ਯੋਗ ਨਹੀਂ। ਐਂਡ-ਟੂ-ਐਂਡ (ਕਲੈਕਸ਼ਨ → QA → ਡਿਲੀਵਰੀ) ਡਾਟਾ ਪਾਈਪਲਾਈਨਾਂ ਬਣਾਉਣ ਵਾਲੀਆਂ ਟੀਮਾਂ ਲਈ, ਸ਼ੈਪ ਦੀਆਂ AI ਸਿਖਲਾਈ ਡੇਟਾ ਸੇਵਾਵਾਂ ਇਸਨੂੰ ਨਿਰੰਤਰ ਸੰਚਾਲਿਤ ਕਰਨ ਵਿੱਚ ਮਦਦ ਕਰ ਸਕਦੀਆਂ ਹਨ।
ਫੈਸਲਾ ਢਾਂਚਾ: ਸਹੀ ਜਾਂਚ ਰਣਨੀਤੀ ਕਿਵੇਂ ਚੁਣਨੀ ਹੈ
ਇਨ-ਹਾਊਸ, ਭੀੜ ਅਤੇ ਪ੍ਰਬੰਧਿਤ ਸੇਵਾਵਾਂ ਦਾ ਸਹੀ ਮਿਸ਼ਰਣ ਚੁਣਨ ਲਈ ਇਹਨਾਂ ਛੇ ਸਵਾਲਾਂ ਦੀ ਵਰਤੋਂ ਕਰੋ:






